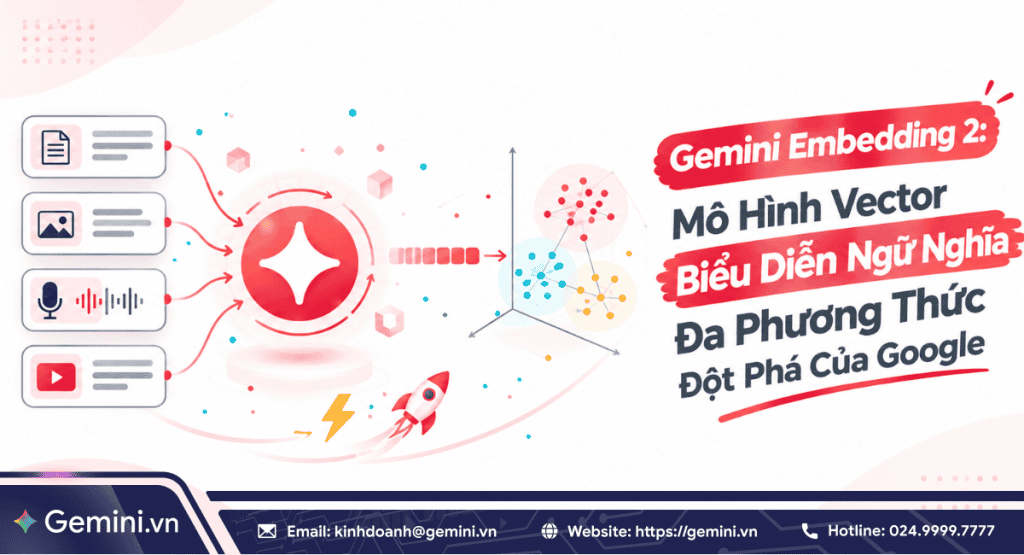
Bạn đang gặp bế tắc khi xây dựng hệ thống RAG hay tìm kiếm ngữ nghĩa vì AI không thể kết nối chính xác dữ liệu văn bản tiếng Việt, sơ đồ kỹ thuật, hình ảnh và mã nguồn lập trình? Việc lưu trữ các chuỗi vector cố định dung lượng khổng lồ không chỉ làm phình to chi phí hạ tầng cơ sở dữ liệu mà còn làm chậm tốc độ truy vấn tri thức của doanh nghiệp. Bài viết dưới đây từ Gemini.vn sẽ phân tích chi tiết mô hình Gemini Embedding 2, giải pháp biểu diễn vector đa phương thức thế hệ mới với kỹ thuật nén chiều Matryoshka (MRL), giúp cắt giảm 80% chi phí lưu trữ và tăng tốc độ trích xuất tri thức chỉ trong vài mili-giây!
Gemini Embedding 2 là gì?
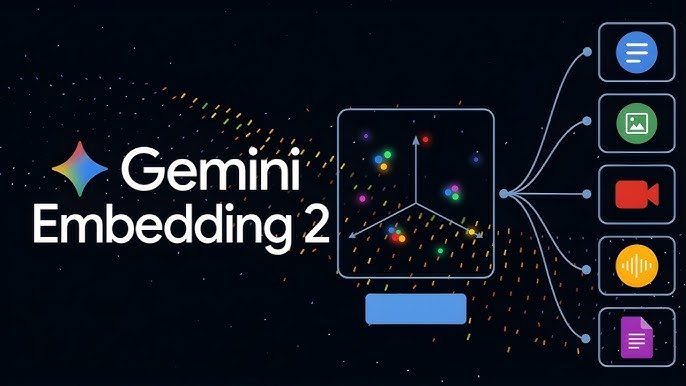
Gemini Embedding 2 là mô hình biểu diễn dữ liệu dạng vector (Vector Embedding Model) thế hệ mới của Google Gemini, sở hữu khả năng ánh xạ đồng thời văn bản, hình ảnh, âm thanh và mã code vào cùng một không gian vector đa chiều để máy tính hiểu chính xác ngữ nghĩa của dữ liệu.
Trong lĩnh vực xử lý ngôn ngữ tự nhiên và trí tuệ nhân tạo, vector embedding là kỹ thuật chuyển đổi dữ liệu thô (như từ ngữ, câu văn, hình ảnh) thành các chuỗi số thực (floating-point numbers) trong không gian đa chiều. Nhờ đó, máy tính có thể thực hiện các phép toán so sánh khoảng cách giữa các vector để xác định độ tương đồng về ngữ nghĩa giữa hai đối tượng dữ liệu bất kỳ.
Điểm đột phá lớn nhất của Gemini Embedding 2 nằm ở kiến trúc đa phương thức gốc (Native Multimodality). Các mô hình thế hệ cũ thường bị giới hạn trong việc biểu diễn văn bản đơn thuần (Text-only Embeddings). Khi muốn xử lý hình ảnh hay âm thanh, hệ thống phải thực hiện thêm bước chuyển đổi trung gian như OCR (nhận diện chữ trên ảnh) hoặc ASR (chuyển giọng nói thành văn bản). Quy trình này gây mất mát ngữ cảnh và làm giảm độ chính xác. Gemini Embedding 2 loại bỏ hoàn toàn các rào cản này bằng cách ánh xạ trực tiếp văn bản, hình ảnh, âm thanh và mã nguồn vào cùng một tọa độ toán học.
Sức mạnh của mô hình này còn đến từ việc tích hợp kỹ thuật nén chiều Matryoshka (Matryoshka Representation Learning – MRL). Trong các mô hình truyền thống, kích thước vector là cố định (ví dụ 1536 chiều). Doanh nghiệp buộc phải lưu trữ toàn bộ chuỗi 1536 số thực này cho mỗi mục dữ liệu, làm tốn kém tài nguyên bộ nhớ trên cơ sở dữ liệu Vector (Vector Database). Với kỹ thuật MRL, Gemini Embedding 2 cô đọng các thông tin quan trọng nhất vào những chiều đầu tiên. Doanh nghiệp có thể chủ động linh hoạt nén kích thước vector xuống 768 hoặc 256 chiều tùy theo nhu cầu, giúp giảm chi phí hạ tầng lưu trữ đến 70% mà vẫn bảo toàn độ chính xác ngữ nghĩa.
Đối với các hệ thống RAG (Retrieval-Augmented Generation), mô hình đóng vai trò như một bộ lọc truy xuất thông tin chính xác. Bằng cách đo lường khoảng cách vector, hệ thống có thể trích xuất đúng tài liệu, biểu đồ hoặc đoạn mã liên quan nhất trong kho dữ liệu khổng lồ, hỗ trợ mô hình ngôn ngữ sinh câu trả lời chuẩn xác và loại bỏ hiện tượng ảo giác AI (Hallucination).
Cơ chế biểu diễn Vector đa phương thức của Gemini Embedding 2
Về bản chất, Gemini Embedding 2 hoạt động như một “phiên dịch viên toán học”. Mô hình này chuyển đổi mọi dữ liệu thô (văn bản, hình ảnh, âm thanh, video) thành các dãy số thực (gọi là Vector) nằm trong không gian không gian đa chiều. Nhờ các chuỗi số này, máy tính có thể nhanh chóng đo đạc khoảng cách toán học để hiểu được mức độ tương đồng về mặt ý nghĩa giữa các dữ liệu với tốc độ cực nhanh.
Đồng bộ không gian ngữ nghĩa đa phương thức (Cross-modal Alignment)
Trước đây, văn bản và hình ảnh sống ở hai “thế giới” hoàn toàn khác nhau đối với máy tính. Với Gemini Embedding 2, mọi dạng dữ liệu dù là đoạn văn, bức ảnh hay tệp âm thanh đều được quy đổi và đưa vào chung một không gian toán học.
- Cách thức hoạt động: Khi hai dữ liệu có nội dung tương đồng (ví dụ: từ khóa văn bản “Sơ đồ kiến trúc hệ thống đám mây” và một bức ảnh chụp sơ đồ hạ tầng AWS), mô hình sẽ tính toán để đặt vị trí tọa độ Vector của chúng nằm sát cạnh nhau trong không gian.
- Giá trị thực tế: Cho phép doanh nghiệp thực hiện tìm kiếm chéo (Cross-modal Search) một cách dễ dàng. Bạn có thể gõ câu lệnh bằng văn bản để tìm ra chính xác hình ảnh hoặc đoạn video tương ứng mà không cần phải tốn công dán nhãn (tagging) thủ công từng tệp tin.
Tối ưu hóa kích thước lưu trữ với kỹ thuật MRL (Matryoshka Representation Learning)
Kỹ thuật này được lấy cảm hứng từ bộ búp bê gỗ Matryoshka của Nga (con búp bê nhỏ nằm gọn trong con búp bê lớn hơn). Mô hình sẽ tự động sắp xếp thông tin quan trọng nhất nằm ở các chiều đầu tiên của dãy Vector, và các chi tiết phụ nằm ở phía sau.
- Cách thức hoạt động: Một chuỗi Vector đầy đủ có thể có kích thước rất lớn (ví dụ: 1536 chiều) để chứa trọn vẹn từng chi tiết nhỏ. Tuy nhiên, nếu hệ thống của bạn cần tiết kiệm bộ nhớ, bạn hoàn toàn có thể “cắt gọt” bớt phần đuôi (chỉ lấy 256 chiều hoặc 512 chiều đầu tiên).
- Giá trị thực tế: Dù bị cắt bớt chiều dài, các thông tin cốt lõi nhất ở phần đầu vẫn được giữ lại trọn vẹn, giúp độ chính xác của mô hình hầu như không bị suy giảm đáng kể. Điều này giúp doanh nghiệp tiết kiệm tới 80% dung lượng lưu trữ trên các hệ thống Big Data và tăng tốc độ truy vấn/tìm kiếm dữ liệu lên gấp nhiều lần.
Thiết lập trọng số theo từng tác vụ chuyên biệt (Task-specific Embeddings)
Mỗi bài toán xử lý dữ liệu lại đòi hỏi một cách biểu diễn Vector khác nhau. Thay vì dùng chung một công thức duy nhất, Gemini Embedding 2 cho phép bạn khai báo tham số task_type để mô hình uốn nắn cấu trúc Vector sao cho phù hợp nhất với mục tiêu sử dụng.
Các định dạng tối ưu phổ biến:
- RETRIEVAL_QUERY: Điều chỉnh Vector dành riêng cho câu truy vấn của người dùng (thường ngắn, mang tính câu hỏi).
- RETRIEVAL_DOCUMENT: Điều chỉnh Vector tối ưu cho tài liệu/văn bản lưu trữ trong cơ sở dữ liệu (thường dài, chứa nhiều thông tin).
- SEMANTIC_SIMILARITY: Tối ưu hóa cho các bài toán so sánh độ tương đồng, giúp xác định hai đoạn văn bản có cùng ý nghĩa hay không.
- CLASSIFICATION & CLUSTERING: Tối ưu hóa đặc tính Vector để phục vụ các thuật toán phân loại dữ liệu hoặc gom nhóm các đối tượng có cùng chủ đề lại với nhau.
Tác động của Gemini Embedding 2 lên kiến trúc RAG và tìm kiếm ngữ nghĩa
Sự ra đời của Gemini Embedding 2 mang lại bước ngoặt chiến lược, trực tiếp giải quyết hai “điểm nghẽn” lớn nhất trong các hệ thống quản trị tri thức doanh nghiệp hiện nay: suy giảm độ chính xác ngữ cảnh và chi phí hạ tầng Big Data.
Bằng việc kết hợp khả năng biểu diễn đa phương thức cùng kỹ thuật linh hoạt số chiều, mô hình nâng cấp toàn diện năng lực của kiến trúc RAG (Retrieval-Augmented Generation) và tìm kiếm ngữ nghĩa:
- Tăng tốc độ trích xuất tri thức đa phương thức: Hệ thống RAG không còn bị giới hạn ở dữ liệu dạng văn bản. Giờ đây, AI có thể quét qua hàng triệu tài liệu, bản vẽ kỹ thuật, sơ đồ, tệp âm thanh hay video và trích xuất đúng thông tin cần thiết chỉ trong vài mili-giây với độ chính xác theo ngữ cảnh cực cao.
- Tối ưu chi phí hạ tầng lưu trữ: Nhờ kỹ thuật MRL cho phép linh hoạt cắt gọt số chiều Vector, doanh nghiệp có thể giảm dung lượng lưu trữ trên các cơ sở dữ liệu Vector (Vector Database) lên tới 70–80% mà vẫn giữ nguyên hiệu suất tìm kiếm ngữ nghĩa.
Bảng so sánh năng lực biểu diễn Vector
| Tiêu chí so sánh | Mô hình Embedding truyền thống | Mô hình Gemini Embedding 2 |
| Loại dữ liệu hỗ trợ | Chủ yếu hỗ trợ văn bản (Text-only) | Đa phương thức (Văn bản, Hình ảnh, Âm thanh, Video, Code) |
| Kích thước Vector | Cố định dung lượng (768 hoặc 1536 chiều) | Tùy chỉnh linh hoạt nhờ MRL (256 đến 1536 chiều) |
| Tối ưu hóa tác vụ | Dùng chung một cấu trúc Vector cho mọi bài toán | Tự điều chỉnh trọng số theo tham số task_type chuyên biệt |
| Hiệu năng hệ thống RAG | Dễ bỏ sót thông tin khi tra cứu tài liệu đa dạng | Trích xuất chính xác tri thức đa nguồn kèm ngữ cảnh |
| Chi phí & Tốc độ truy xuất | Tốn nhiều tài nguyên bộ nhớ khi dữ liệu phình to | Tốc độ phản hồi cực nhanh, tối ưu chi phí lưu trữ Big Data |
Gemini Embedding 2 chính là xương sống cho các hệ thống RAG thế hệ mới. Việc xóa bỏ rào cản giữa các dạng dữ liệu và linh hoạt hóa dung lượng lưu trữ giúp doanh nghiệp xây dựng những kho tri thức thông minh, truy vấn siêu tốc với chi phí vận hành tối ưu nhất.
Ứng dụng thực tế của Gemini Embedding 2 trong doanh nghiệp
Nhờ khả năng xử lý đa phương thức và tùy chỉnh kích thước vector, Gemini Embedding 2 giúp doanh nghiệp khai thác tối đa dữ liệu thông qua 4 ứng dụng thực tế: Xây dựng hệ thống RAG tìm kiếm tri thức nội bộ doanh nghiệp, Tìm kiếm đa phương thức (Multimodal Search) cho thương mại điện tử, Phân loại và gom cụm dữ liệu quy mô lớn (Clustering & Classification) và Tra cứu và phân tích mã nguồn phần mềm (Code Search & Intelligence).
Xây dựng hệ thống RAG tìm kiếm tri thức nội bộ doanh nghiệp
Việc quản trị và khai thác tài sản tri thức luôn là bài toán hóc chuẩn của nhiều doanh nghiệp khi quy mô nhân sự và dữ liệu phình to. Nhờ sự hỗ trợ của Gemini Embedding 2, kiến trúc RAG (Retrieval-Augmented Generation) được nâng cấp thành một kho tra cứu tri thức siêu tốc và chuẩn xác cho toàn bộ tổ chức
- Thực trạng: Kho tri thức doanh nghiệp thường phân tán dưới vô số định dạng từ hợp đồng PDF, slide thuyết trình, bản vẽ CAD cho đến video đào tạo kiến nhân viên tốn hàng giờ tìm kiếm thông tin thủ công.
- Cách Gemini Embedding 2 xử lý: Hệ thống chuyển đổi toàn bộ tài liệu đa phương thức thành các chuỗi vector ngữ nghĩa. Khi nhân viên nhập câu hỏi (ví dụ: “Quy trình xử lý sự cố máy chủ ở đâu?”), hệ thống RAG lập tức quét không gian vector và trích xuất chính xác đoạn văn bản, sơ đồ kỹ thuật hay phân đoạn video chứa câu trả lời mà không bị bỏ sót thông tin.
Tìm kiếm đa phương thức (Multimodal Search) cho thương mại điện tử
Trong ngành bán lẻ trực tuyến, khoảng cách giữa nhu cầu của khách hàng và từ khóa tìm kiếm chính là rào cản làm suy giảm tỷ lệ chuyển đổi. Gemini Embedding 2 giúp xóa bỏ hoàn toàn rào cản ngôn ngữ này bằng cách đưa năng lực tìm kiếm bằng hình ảnh, âm thanh và ngữ cảnh thực tế vào hệ thống E-commerce.
- Thực trạng: Tìm kiếm bằng từ khóa truyền thống trên các trang E-commerce rất dễ bỏ sót sản phẩm nếu người dùng không gõ đúng tên hoặc nhãn (tag) mà hệ thống đã đặt.
- Cách Gemini Embedding 2 xử lý: Khách hàng chỉ cần tải lên bức ảnh chụp trang phục yêu thích hoặc đọc một đoạn thoại mô tả kiểu dáng. AI quy đổi tệp ảnh/âm thanh này thành vector và đối chiếu trực tiếp với kho dữ liệu sản phẩm. Hệ thống sẽ trả về ngay lập tức các sản phẩm có kiểu dáng, màu sắc tương đồng mà hoàn toàn không phụ thuộc vào nhãn dán thủ công.
Phân loại và gom cụm dữ liệu quy mô lớn (Clustering & Classification)
Xử lý và thấu hiểu khối lượng dữ liệu khổng lồ từ thị trường luôn là thách thức lớn đối với năng lực phân tích của mọi doanh nghiệp. Sự can thiệp của Gemini Embedding 2 giúp tự động hóa quá trình phân tích ngữ nghĩa, biến Big Data thô thành những hiểu biết kinh doanh (business insights) mang lại giá trị tức thì.
- Thực trạng: Doanh nghiệp phải xử lý hàng triệu phản hồi khách hàng (feedback), đánh giá dịch vụ hoặc giao dịch tài chính mỗi ngày nhưng không đủ nhân lực để đọc và phân loại hết.
- Cách Gemini Embedding 2 xử lý: AI mã hóa toàn bộ dữ liệu phản hồi thành vector và gom nhóm (clustering) tự động theo bản chất ngữ nghĩa. Nhà quản trị có thể ngay lập tức nhìn thấy các nhóm vấn đề nổi cộm (như “Lỗi giao diện ứng dụng”, “Thái độ nhân viên giao hàng”) hay các xu hướng thị trường mới để kịp thời điều chỉnh chiến lược.
Tra cứu và phân tích mã nguồn phần mềm (Code Search & Intelligence)
Đối với các đội ngũ phát triển phần mềm, việc thấu hiểu cấu trúc tổng thể của những hệ thống quy mô lớn luôn đòi hỏi rất nhiều thời gian và công sức. Nhờ khả năng phân tích mã nguồn và chuyển đổi cú pháp lập trình thành không gian ngữ nghĩa, Gemini Embedding 2 trở thành trợ lý đắc lực giúp tối ưu hóa hiệu suất làm việc của các kỹ sư công nghệ.
- Thực trạng: Trong các dự án công nghệ lớn có hàng triệu dòng code, việc lập trình viên mới tìm kiếm một hàm (function) hay tính năng cụ thể tốn rất nhiều thời gian đọc lại tài liệu hướng dẫn.
- Cách Gemini Embedding 2 xử lý: Lập trình viên mã hóa toàn bộ cơ sở mã nguồn (Source Code) thành không gian vector. Khi cần tìm một chức năng, kỹ sư chỉ cần gõ yêu cầu bằng ngôn ngữ tự nhiên (như “Tìm hàm tính phí vận chuyển theo khoảng cách”), AI sẽ chỉ ra chính xác tệp tin, dòng code và ngữ cảnh sử dụng tương ứng.
Để khai thác trọn vẹn sức mạnh của Gemini Embedding 2 cùng các mô hình AI nâng cao trong hệ sinh thái Google, bạn có thể tham khảo các giải pháp tại Gemini.vn nhằm lựa chọn phương án phù hợp với nhu cầu cá nhân hoặc doanh nghiệp. Truy cập bảng giá hoặc liên hệ để được tư vấn và hỗ trợ ứng dụng AI vào quy trình làm việc thực tế.
Các câu hỏi thường gặp (FAQ)
Giải đáp trực tiếp các thắc mắc phổ biến giúp doanh nghiệp triển khai mô hình Gemini Embedding 2 an toàn, chính xác và hiệu quả.
Gemini Embedding 2 khác gì so với mô hình ngôn ngữ Gemini thông thường?
Mô hình Gemini thông thường tiếp nhận và sinh ra nội dung văn bản/hình ảnh mới (Generative AI). Trong khi đó, Gemini Embedding 2 chuyển đổi dữ liệu thành các mảng số vector để phục vụ cho các tác vụ tìm kiếm, so sánh độ tương đồng và phân loại dữ liệu.
Kỹ thuật MRL trong Gemini Embedding 2 mang lại lợi ích gì về chi phí?
Kỹ thuật MRL cho phép cắt giảm số chiều của vector (ví dụ từ 1536 xuống 256 chiều), giúp giảm dung lượng bộ nhớ lưu trữ trên cơ sở dữ liệu và tăng tốc độ tính toán truy vấn mà không làm mất đi ngữ nghĩa cốt lõi.
Mô hình này có hỗ trợ xử lý dữ liệu tiếng Việt tốt không?
Có. Mô hình hỗ trợ xử lý đa ngôn ngữ (bao gồm tiếng Việt) và đa phương thức, nhận diện chính xác khoảng cách ngữ nghĩa trong các hệ thống trích xuất tri thức.
Dữ liệu khi chuyển đổi thành Vector có được bảo mật không?
Toàn bộ dữ liệu xử lý trên môi trường Google Cloud doanh nghiệp đều được mã hóa an toàn, cam kết không bị rò rỉ hay bị dùng để huấn luyện các mô hình AI công cộng.
Sử dụng Gemini Embedding 2 có cần hạ tầng phần cứng chuyên dụng không?
Không. Mọi tác vụ chuyển đổi và tính toán Vector đều chạy trực tiếp trên hạ tầng đám mây Google Cloud qua API, doanh nghiệp không cần đầu tư phần cứng GPU/TPU nội bộ.
Tổng kết
Mô hình Gemini Embedding 2 đánh dấu bước tiến quan trọng trong việc chuẩn hóa dữ liệu đa phương thức thành không gian vector toán học thống nhất. Việc ứng dụng công nghệ này giúp cá nhân và doanh nghiệp tối ưu hóa hiệu năng hệ thống RAG, rút ngắn thời gian tìm kiếm tri thức và xây dựng hạ tầng dữ liệu thông minh cực kỳ hiệu quả trong kỷ nguyên số.
Nếu bạn đang cần trải nghiệm sử dụng Gemini AI phiên bản mới nhất vui lòng liên hệ đến Gemini.vn qua Hotline 024.9999.7777.
