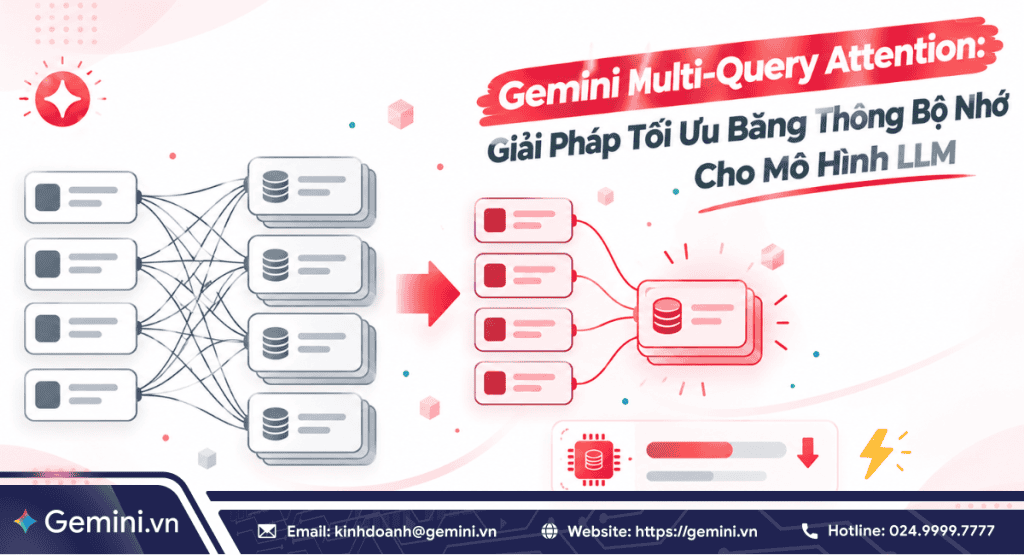
Doanh nghiệp của bạn có đang chịu cảnh hệ thống AI gián đoạn, giật lag hay phản hồi chậm chạp mỗi khi yêu cầu xử lý các bộ tài liệu dài hàng triệu token hay phân tích mã nguồn phức tạp? Nguyên nhân cốt lõi nằm ở nút thắt băng thông bộ nhớ khi lưu trữ KV Cache trong các kiến trúc Transformer truyền thống, gây tràn VRAM và đẩy chi phí hạ tầng máy chủ lên mức đắt đỏ.
Bài viết sau Gemini.vn sẽ phân tích chuyên sâu Gemini Multi-Query Attention (MQA) – giải pháp nén bộ nhớ tạm đột phá từ Google giúp phân chia và chia sẻ cặp Key-Value thông minh. Công nghệ này loại bỏ triệt để tình trạng nghẽn băng thông, giải phóng dung lượng RAM/VRAM và tăng tốc độ suy luận mượt mà cho cửa sổ ngữ cảnh siêu lớn, mang lại đòn bẩy tối ưu chi phí vận hành AI vượt trội cho doanh nghiệp!
Gemini Multi-Query Attention là gì?
Gemini Multi-Query Attention (MQA) là cơ chế chú ý nâng cao trong kiến trúc mạng Transformer của Google Gemini, cho phép nhiều đầu truy vấn (Query heads) chia sẻ chung một cặp đầu Key và Value, giúp giải quyết triệt để rào cản băng thông bộ nhớ và tăng tốc độ suy luận của mô hình LLM.
Để hiểu rõ giá trị của kỹ thuật này, cần nhìn lại cơ chế chú ý tự thân (Self-Attention) – trái tim của kiến trúc Transformer. Trong mô hình Transformer truyền thống, mỗi từ ngữ đầu vào được biểu diễn qua 3 ma trận chính: Query (Q – từ cần tìm ngữ cảnh), Key (K – từ cung cấp ngữ cảnh) và Value (V – thông tin ngữ nghĩa tích hợp). Việc tính toán mối quan hệ giữa Q,K,V giúp mô hình hiểu được sự kết nối giữa các từ trong một đoạn văn phức tạp.
Trong kiến trúc Multi-Head Attention (MHA) truyền thống, mô hình sử dụng H đầu chú ý song song. Mỗi đầu sở hữu một bộ ma trận Q,K,V hoàn toàn riêng biệt. Mặc dù MHA mang lại khả năng học ngữ nghĩa đa dạng, nó lại tạo ra một gánh nặng bộ nhớ rất lớn: khi mô hình sinh ra từng từ tiếp theo (Autoregressive Decoding), nó buộc phải lưu trữ toàn bộ các cặp K và V của tất cả các từ trước đó vào một vùng nhớ tạm gọi là KV Cache. Khi chiều dài văn bản lên tới hàng ngàn hoặc hàng triệu token, dung lượng KV Cache sẽ phình to vượt quá khả năng lưu trữ của bộ nhớ HBM (High Bandwidth Memory) trên chip GPU hoặc TPU.
Sự ra đời của Gemini Multi-Query Attention tạo nên bước chuyển dịch kỹ thuật mang tính đột phá. Trong MQA, mô hình vẫn duy trì H đầu Query để phân tích ngữ nghĩa đa chiều của văn bản, nhưng tất cả các đầu Query này sẽ dùng chung đúng 1 đầu Key và 1 đầu Value duy nhất.
Thay đổi kiến trúc này mang lại những bước tiến quan trọng cho Gemini:
- Giải quyết băng thông bộ nhớ: Trong giai đoạn tạo ra từng từ nối tiếp nhau, tốc độ của AI bị giới hạn bởi tốc độ đọc/ghi dữ liệu KV Cache từ bộ nhớ HBM vào lõi tính toán. MQA giảm số lượng ma trận K và V phải đọc/ghi đi H lần, giúp tốc độ phản hồi diễn ra cực nhanh.
- Tiết kiệm dung lượng RAM/VRAM: Dung lượng KV Cache cần thiết cho mỗi phiên làm việc được thu nhỏ đáng kể, cho phép hệ thống lưu trữ được hàng triệu token ngữ cảnh mà không gây tràn bộ nhớ.
- Nâng cao khả năng xử lý song song: Việc giảm dấu chân bộ nhớ (memory footprint) giúp cụm máy chủ Google TPU có thể gom nhiều câu truy vấn của người dùng vào cùng một lượt xử lý (batching), tối ưu hóa hiệu suất phục vụ trên quy mô lớn.
Cơ chế vận hành kỹ thuật của Gemini Multi-Query Attention
Cơ chế vận hành của Gemini Multi-Query Attention dựa trên việc gom nhóm và chia sẻ không gian vector Key – Value cho tất cả các Query head, cắt giảm tối đa dung lượng KV Cache cần nạp vào bộ nhớ chip TPU/GPU trong mỗi bước giải mã.
Cơ chế chia sẻ đầu Key và Value (KV Cache Sharing)
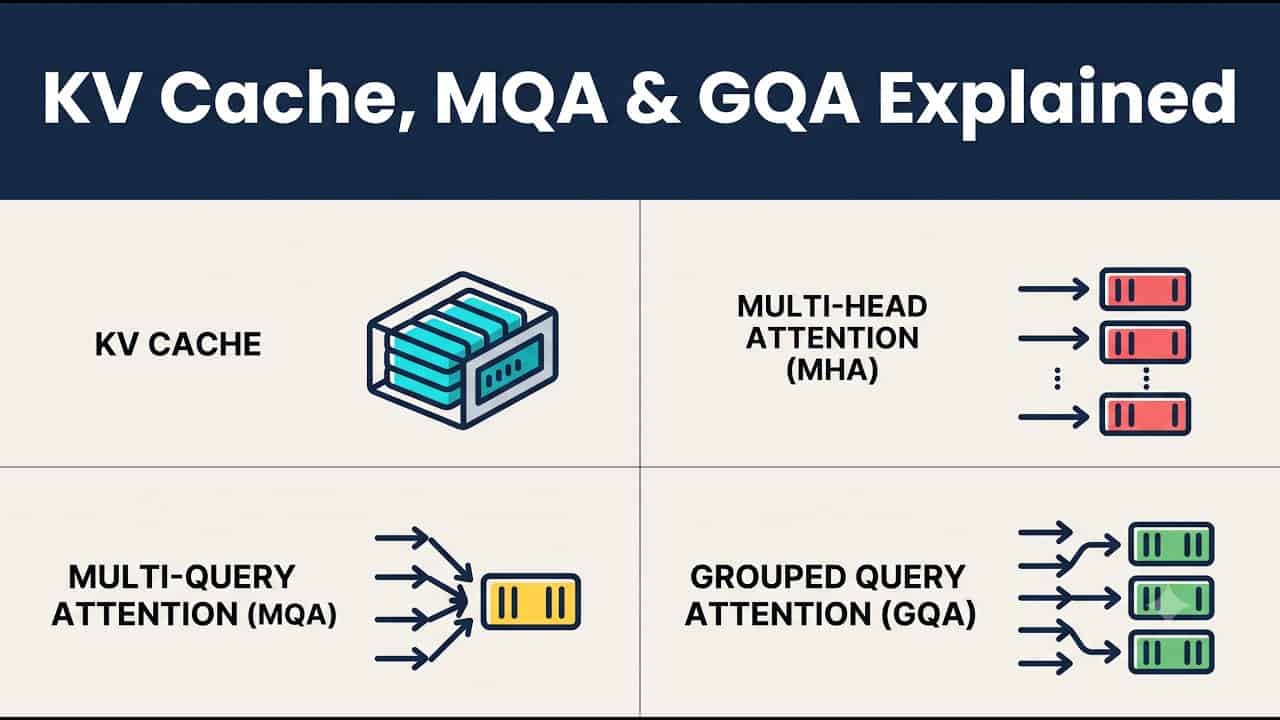
Mô hình toán học của MQA thực hiện việc chiếu (projection) vector đầu vào thành H ma trận Q khác nhau (Q1,Q2,…,QH), đại diện cho các góc nhìn phân tích ngữ cảnh khác nhau. Tuy nhiên, thay vì tạo ra H ma trận K và H ma trận V, mô hình chỉ thực hiện đúng 1 phép chiếu cho K và 1 phép chiếu cho V.
Khi thực hiện tính toán ma trận Attention score, mỗi đầu Query Qi sẽ cùng nhân với ma trận K chung và trích xuất thông tin từ ma trận V chung. Nhờ đó, kích thước ma trận trọng số K và V cần lưu trữ giảm đi đúng H lần (ví dụ: nếu mô hình có 80 đầu chú ý, dung lượng KV Cache của K và V sẽ giảm đi 80 lần).
Nén dung lượng bộ nhớ trong giai đoạn Autoregressive Decoding
Khi mô hình Gemini dự đoán từng từ tiếp theo trong chuỗi câu, bước xử lý này diễn ra theo cơ chế nối tiếp. Ở mỗi bước, chip xử lý phải nạp toàn bộ lịch sử KV Cache của các từ trước đó từ bộ nhớ ngoài vào bộ đệm của chip để tính toán. Với MHA truyền thống, lượng dữ liệu trung chuyển này rất lớn, khiến chip tính toán phải chờ bộ nhớ truyền dữ liệu.
Với Gemini Multi-Query Attention, lượng dữ liệu KV Cache cần nạp cực kỳ nhỏ gọn. Điều này giúp loại bỏ hoàn toàn thời gian chờ của chip, biến quá trình suy luận từ trạng thái bị nghẽn bộ nhớ (Memory-bound) sang trạng thái tối ưu hóa tính toán (Compute-bound), giúp thời gian sinh từ tăng tốc đáng kể.
Tối ưu hóa khả năng mở rộng Batch Size trên hạ tầng Google TPU
Chip Google TPU v5e hay TPU v6 được thiết kế để xử lý các phép toán ma trận mật độ cao. Khi dung lượng bộ nhớ dành cho KV Cache của một người dùng giảm xuống, hệ thống có thể tăng chỉ số Batch Size – tức là phục vụ cùng lúc hàng trăm người dùng trên cùng một chip xử lý mà không sợ quá tải VRAM. Điều này đóng vai trò then chốt giúp dịch vụ Gemini duy trì độ ổn định cao ngay cả trong các khung giờ cao điểm.
Tác động của Gemini Multi-Query Attention lên hệ sinh thái Google
Việc tích hợp Gemini Multi-Query Attention mang lại bước ngoặt lớn, đóng vai trò là nền tảng kỹ thuật cho phép Gemini xử lý Cửa sổ ngữ cảnh siêu lớn (Long Context Window) với độ trễ thấp và hiệu suất phục vụ cao.
Sự phát triển của kiến trúc MQA chính là chìa khóa mở đường cho tính năng xử lý ngữ cảnh từ 1 triệu đến hơn 2 triệu token trên các phiên bản Gemini Pro và Gemini Ultra. Nếu sử dụng kiến trúc MHA cũ, việc duy trì bộ nhớ tạm cho 2 triệu token sẽ đòi hỏi hàng trăm GB VRAM chỉ để chứa KV Cache cho một câu truy vấn duy nhất điều hoàn toàn không khả thi về mặt kinh tế và kỹ thuật. MQA giúp nén dữ liệu này xuống mức an toàn, cho phép AI đọc hiểu toàn bộ kho sách, mã nguồn hay video dài chỉ trong một phiên làm việc.
Bảng so sánh các biến thể cơ chế Attention trong LLM
Dưới đây là bảng so sánh trực quan giữa các kiến trúc Attention phổ biến được áp dụng trên các mô hình ngôn ngữ lớn hiện nay:
| Tiêu chí so sánh | Multi-Head Attention (MHA) | Grouped-Query Attention (GQA) | Gemini Multi-Query Attention (MQA) |
| Số lượng đầu Key/Value | Bằng số đầu Query (H) | Chia thành G nhóm nhỏ | Duy nhất 1 đầu K và 1 đầu V |
| Dung lượng KV Cache | Cao (dễ gây tràn bộ nhớ VRAM) | Trung bình (mức cân bằng) | Thấp (tiết kiệm bộ nhớ tối đa) |
| Tốc độ suy luận (Inference) | Chậm do nghẽn băng thông bộ nhớ | Nhanh | Cực nhanh |
| Khả năng mở rộng ngữ cảnh | Bị giới hạn ở độ dài ngắn | Khá tốt | Hỗ trợ siêu dài (1M-2M+ token) |
| Tác động tới độ chính xác | Bảo toàn tối đa chi tiết ngữ nghĩa | Gần tương đương MHA | Giữ vững độ chính xác nhờ huấn luyện lớn |
Tích hợp Gemini Multi-Query Attention không đơn thuần là một nâng cấp hạ tầng, mà là bước ngoặt kiến trúc chiến lược giúp Google làm chủ cuộc đua LLM. Bằng cách giải triệt để bài toán bộ nhớ của KV Cache, MQA đã biến khả năng xử lý cửa sổ ngữ cảnh siêu lớn (1M–2M+ token) từ một ý tưởng đắt đỏ trên lý thuyết trở thành hiện thực thương mại khả thi cho phép Gemini đọc hiểu toàn bộ kho tài liệu, video dài hay mã nguồn phức tạp chỉ trong một truy vấn.
4 Ứng dụng thực tế của Gemini Multi-Query Attention (MQA) với doanh nghiệp
Gemini Multi-Query Attention (MQA) giúp doanh nghiệp tối ưu vận hành thông qua 4 ứng dụng thực tế: phân tích tài liệu siêu dài, tăng tốc phản hồi cho chatbot, xử lý hàng ngàn truy cập đồng thời và cắt giảm chi phí hạ tầng.
Đọc hiểu trọn vẹn và phân tích các tài liệu siêu dài
Trong các ngành như pháp lý, tài chính hay y học, nhân sự thường phải xử lý những bộ hồ sơ dài hàng ngàn trang. Các mô hình AI trước đây thường phải cắt nhỏ tài liệu ra để đọc, dễ dẫn đến việc hiểu sai ngữ cảnh hoặc bỏ sót thông tin liên kết.
Giải pháp với MQA: Nhờ khả năng tối ưu hóa bộ nhớ, Gemini có thể nhập toàn bộ một hợp đồng khổng lồ, sách hướng dẫn vận hành hay lịch sử giao dịch nhiều năm vào hệ thống để xử lý trong một lần duy nhất. AI sẽ hiểu được toàn bộ bức tranh tổng thể, giúp trích xuất thông tin chuẩn xác 100% mà không bị đứt gãy ngữ cảnh.
Nâng cấp tốc độ phản hồi cho Chatbot và Trợ lý ảo AI
Trong dịch vụ khách hàng, việc phải chờ đợi chatbot suy nghĩ quá lâu sẽ khiến người dùng khó chịu và rời bỏ hệ thống.
Giải pháp với MQA: Công nghệ này rút ngắn tối đa thời gian AI bắt đầu đưa ra câu trả lời (Time-to-First-Token). Thay vì bắt người dùng nhìn biểu tượng chờ đợi, trợ lý ảo sẽ phản hồi gần như lập tức ngay khi nhận được câu hỏi. Tốc độ này giúp các cuộc trò chuyện tự động trở nên tự nhiên, mượt mà và giống với con người hơn.
Xử lý mượt mà hàng ngàn người dùng truy cập cùng lúc
Các nền tảng phần mềm hoặc ứng dụng thường xuyên bị quá tải, nghẽn mạng khi có lượng lớn khách hàng đăng nhập và sử dụng AI cùng một thời điểm (ví dụ: các dịp siêu sale, sự kiện lớn).
Giải pháp với MQA: MQA giúp giải phóng áp lực lên bộ nhớ của các máy chủ phần cứng (chip TPU/GPU). Nhờ đó, hạ tầng hệ thống nhạy bén hơn và có thể tự động mở rộng để phục vụ hàng ngàn yêu cầu song song. Doanh nghiệp sẽ duy trì được dịch vụ ổn định, không lo gián đoạn ngay cả trong những khung giờ cao điểm nhất.
Cắt giảm tối đa chi phí máy chủ và vận hành đám mây
Chi phí duy trì hệ thống máy chủ và trả tiền cho các lượt gọi API để duy trì AI thường là một gánh nặng tài chính lớn đối với doanh nghiệp.
Giải pháp với MQA: Vì MQA cho phép xử lý lượng dữ liệu dày đặc hơn trên cùng một thiết bị máy chủ, chi phí để AI tính toán và tạo ra từng câu trả lời được giảm xuống mức thấp nhất. Khi doanh nghiệp sử dụng Gemini qua nền tảng Google Cloud Vertex AI, họ sẽ tiết kiệm được một khoản lớn ngân sách hạ tầng, đảm bảo các dự án chuyển đổi số thực sự sinh lời và đạt hiệu quả kinh tế cao.
Để khai thác trọn vẹn tốc độ xử lý vượt trội của kiến trúc Gemini Multi-Query Attention cùng các tính năng AI nâng cao, việc trang bị gói dịch vụ chính hãng là lựa chọn tối ưu cho doanh nghiệp. Bạn có thể tham khảo chi tiết chi phí tại đây để nhận được hỗ trợ trực tiếp từ đội ngũ chuyên gia.
Các câu hỏi thường gặp (FAQ)
Giải đáp trực tiếp các thắc mắc kỹ thuật phổ biến giúp bạn hiểu rõ nguyên lý vận hành và lợi ích của Gemini Multi-Query Attention.
Gemini Multi-Query Attention khác gì so với Multi-Head Attention thông thường?
Multi-Head Attention tạo ra các bộ Key và Value riêng biệt cho từng đầu chú ý, gây tốn bộ nhớ. Trong khi đó, Gemini Multi-Query Attention giữ lại nhiều đầu Query nhưng cho tất cả các đầu dùng chung 1 cặp Key và Value duy nhất, giúp giảm dung lượng bộ nhớ tạm và tăng tốc độ suy luận.
Việc dùng chung một cặp Key và Value trong MQA có làm giảm độ thông minh của Gemini không?
Không đáng kể. Nhờ được huấn luyện trên tập dữ liệu quy mô khổng lồ cùng các kỹ thuật tối ưu hóa trọng số tiên tiến của Google, Gemini vẫn duy trì độ chuẩn xác cao trong các bài kiểm tra tư duy phức tạp trong khi tốc độ xử lý được cải thiện vượt trội.
Tại sao Multi-Query Attention lại đóng vai trò quan trọng đối với Cửa sổ ngữ cảnh dài (Long Context Window)?
Khi xử lý tài liệu dài hàng triệu token, dung lượng KV Cache của kiến trúc MHA cũ sẽ vượt quá khả năng lưu trữ của bộ nhớ chip. MQA nén dung lượng KV Cache xuống nhiều lần, cho phép Gemini đọc hiểu toàn bộ tệp dữ liệu lớn mượt mà mà không lo tràn bộ nhớ.
Lập trình viên có cần tự cấu hình thuật toán Multi-Query Attention khi gọi API Gemini không?
Không. Multi-Query Attention là kiến trúc cốt lõi được Google xây dựng sẵn bên trong mô hình Gemini. Khi doanh nghiệp gọi API thông qua Google Cloud Vertex AI hay Google AI Studio, ứng dụng sẽ tự động hưởng lợi về tốc độ phản hồi và độ trễ thấp.
Tổng kết
Kỹ thuật Gemini Multi-Query Attention là một trong những cải tiến kiến trúc quan trọng giúp Google bứt phá giới hạn xử lý của mô hình ngôn ngữ lớn. Bằng cách giải quyết vấn đề nghẽn băng thông bộ nhớ và tối ưu dung lượng KV Cache, MQA mang lại khả năng xử lý ngữ cảnh siêu dài với tốc độ phản hồi cực nhanh, giúp các doanh nghiệp tối ưu hóa chi phí vận hành và nâng cao hiệu suất làm việc vượt trội trong kỷ nguyên AI.
Với những thông tin chi tiết được chúng tôi chia sẻ trên đây, nếu bạn cần hỗ trợ tư vấn và đăng ký dịch vụ Gemini AI bản quyền vui lòng liên hệ đến Gemini.vn qua Hotline 024.9999.7777.
