ARC-AGI-2 là phiên bản nâng cấp của bộ tiêu chuẩn đánh giá AI (benchmark) đánh giá khả năng suy luận trừu tượng và khái quát hóa của AI thông qua các bài toán nhận diện quy luật, giải quyết những tình huống mới. Thay vì chỉ kiểm tra kiến thức đã học, bài đánh giá tập trung vào khả năng vận dụng tư duy để xử lý những vấn đề chưa từng gặp. Vậy ARC-AGI-2 được xây dựng và chấm điểm như thế nào? Bài viết Gemini.vn sẽ giúp bạn tìm hiểu cấu trúc, độ khó của benchmark và kết quả của Google Gemini trên bài kiểm tra này.
ARC-AGI-2 là gì?
ARC-AGI-2 là một benchmark đánh giá khả năng suy luận trừu tượng và khái quát hóa quy luật của hệ thống AI thông qua các bài toán dạng lưới hình ảnh. Đây là phiên bản tiếp theo của ARC-AGI-1, được phát triển bởi ARC Prize Foundation nhằm kiểm tra sâu hơn năng lực suy luận của các mô hình AI hiện đại.
Khác với những bài kiểm tra chủ yếu đánh giá kiến thức có sẵn, ARC-AGI-2 yêu cầu hệ thống quan sát các ví dụ đầu vào – đầu ra, tìm ra quy luật ẩn và áp dụng quy luật đó vào một trường hợp chưa từng thấy. Nhờ vậy, benchmark có thể giúp đánh giá liệu AI có thực sự khái quát hóa được từ một số ví dụ hay chỉ đang nhận diện những mẫu hình quen thuộc.
Theo thông tin từ ARC Prize Foundation, ARC-AGI-2 được giới thiệu vào năm 2025, với mục tiêu thử thách những hệ thống suy luận AI tiên tiến và thúc đẩy nghiên cứu về trí tuệ nhân tạo tổng quát (AGI). Bộ đánh giá cũng chú trọng đến hiệu quả tính toán, thay vì chỉ xem xét AI giải được bao nhiêu câu hỏi.
ARC-AGI-2 chủ yếu sẽ tập trung vào các năng lực liên quan đến việc giải quyết vấn đề mới, bao gồm:
- Suy luận trừu tượng (abstract reasoning): Nhận ra quy luật chung từ những hình ảnh hoặc dữ liệu cụ thể.
- Nhận diện quy luật (pattern recognition): Phát hiện mối quan hệ giữa các hình dạng, màu sắc, vị trí và cấu trúc trong lưới.
- Khái quát hóa (generalization): Áp dụng quy tắc đã suy ra vào một bài toán mới, thay vì chỉ lặp lại ví dụ từng gặp.
- Diễn giải ký hiệu (symbolic interpretation): Xác định ý nghĩa của các yếu tố trong bài toán thay vì chỉ nhận diện hình thức bên ngoài.
- Suy luận tổ hợp (compositional reasoning): Kết hợp nhiều quy tắc có thể tương tác với nhau để tìm ra đáp án.
- Áp dụng quy tắc theo ngữ cảnh (contextual rule application): Điều chỉnh cách áp dụng quy tắc dựa trên tình huống cụ thể.
Những năng lực này đặc biệt quan trọng khi đánh giá các mô hình ngôn ngữ lớn (LLM) và hệ thống AI có khả năng suy luận nhiều bước. Một mô hình có thể trả lời tốt câu hỏi kiến thức nhưng vẫn gặp khó khăn khi phải tự tìm ra quy luật chưa được mô tả bằng lời.
ARC-AGI-2 hoạt động như thế nào?
Để hiểu cách ARC-AGI-2 đánh giá năng lực AI, hãy hình dung một bài toán gồm vài cặp lưới màu. Mỗi cặp thể hiện một lưới đầu vào và kết quả tương ứng sau khi áp dụng một quy tắc chưa được giải thích. Nhiệm vụ của AI là quan sát các ví dụ, xác định phép biến đổi đang được sử dụng rồi dự đoán kết quả cho một lưới mới. Điểm khó nằm ở chỗ quy tắc không được cung cấp trực tiếp bằng văn bản, nên hệ thống phải tự suy luận từ dữ liệu.
Cấu trúc bộ dữ liệu ARC-AGI-2
Theo tài liệu chính thức của ARC Prize Foundation, ARC-AGI-2 có tổng cộng 1.360 bài toán, được chia thành tập huấn luyện và các tập đánh giá.
| Thành phần | Số lượng | Mục đích |
| Training Set | 1.000 bài | Dữ liệu công khai để nghiên cứu, phát triển và huấn luyện hệ thống |
| Public Eval Set | 120 bài | Đánh giá công khai |
| Semi-Private Eval Set | 120 bài | Đánh giá trên tập không công khai hoàn toàn, phục vụ bảng xếp hạng |
| Private Eval Set | 120 bài | Đánh giá kín, dùng cho kết quả chung cuộc của cuộc thi |
ARC-AGI-2 gồm 360 bài toán, được chia thành ba tập dữ liệu: công khai, bán riêng tư và riêng tư. Cách phân chia này giúp hạn chế tình trạng mô hình hoặc nhóm phát triển tối ưu trực tiếp theo đáp án có sẵn. Tuy nhiên, dữ liệu công khai vẫn có thể được sử dụng trong quá trình nghiên cứu và phát triển phương pháp giải. Vì vậy, khi đánh giá kết quả, cần xem xét tập dữ liệu và điều kiện thử nghiệm thay vì chỉ dựa vào một con số phần trăm.
Cách tính điểm ARC-AGI-2
ARC-AGI-2 sử dụng cách chấm điểm thường được gọi là pass@2. Với mỗi bài toán đánh giá, hệ thống được đưa ra tối đa hai dự đoán cho đầu ra cần tìm. Nếu ít nhất một dự đoán khớp chính xác với đáp án chuẩn, bài toán được tính là giải đúng.
Ví dụ, AI nhận được một lưới hình ảnh mới và đưa ra hai phương án kết quả. Nếu phương án thứ hai khớp hoàn toàn với đáp án chuẩn, bài toán vẫn được tính là thành công. Ngược lại, nếu cả hai phương án đều sai, hệ thống không được tính điểm cho bài toán đó.
Điểm tổng thể thể hiện tỷ lệ bài toán được giải đúng trong tập đánh giá. Dù vậy, để so sánh công bằng giữa các mô hình, cần kiểm tra thêm cấu hình chạy, ngân sách tính toán và chi phí để đạt được kết quả.
ARC Prize Foundation cũng nhấn mạnh yếu tố hiệu quả: giải được bài toán là chưa đủ nếu hệ thống phải tiêu tốn lượng tài nguyên quá lớn. Do đó, chi phí tính toán trên mỗi bài toán được giải là một khía cạnh cần xem xét khi phân tích năng lực AI.
Vì sao ARC-AGI-2 được xem là benchmark khó với AI?
Điểm đặc biệt của ARC-AGI-2 không nằm ở việc yêu cầu AI ghi nhớ thật nhiều dữ liệu, mà ở việc buộc hệ thống suy ra quy luật từ một số ví dụ rồi áp dụng vào trường hợp mới.
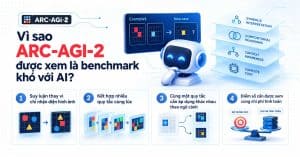
Theo ARC Prize Foundation, benchmark tập trung vào những điểm yếu của các hệ thống AI, đặc biệt là khả năng diễn giải ký hiệu, kết hợp nhiều quy tắc và áp dụng quy tắc phù hợp với ngữ cảnh. Các bài toán dễ bị giải bằng tìm kiếm vét cạn trong bộ ARC-AGI ban đầu cũng đã được loại khỏi các tập đánh giá của phiên bản mới.
1. AI phải suy luận thay vì chỉ nhận diện hình ảnh
Một mô hình có thể nhận biết hình vuông, hình tròn hoặc các ô màu trong lưới. Tuy nhiên, nhận diện được các thành phần chưa đồng nghĩa với việc hiểu mối quan hệ giữa chúng. Chẳng hạn, một bài toán có thể yêu cầu hệ thống xác định rằng một hình dạng đóng vai trò đánh dấu, còn một hình khác cho biết vị trí cần biến đổi. Nếu AI chỉ chú ý đến màu sắc hoặc đối xứng, mô hình có thể bỏ qua ý nghĩa của các ký hiệu và đưa ra đáp án sai.
Đây là lý do ARC-AGI-2 chú trọng đến symbolic interpretation: AI cần xác định vai trò của các yếu tố trong bài toán, không chỉ mô tả những gì nhìn thấy.
2. Nhiều quy tắc có thể phải được áp dụng đồng thời
Một số bài toán yêu cầu kết hợp nhiều phép biến đổi, ví dụ minh họa như hệ thống có thể cần xác định hình nào được giữ lại, thay đổi màu của một số ô rồi sắp xếp lại vị trí theo quy luật khác. Nếu AI chỉ tìm được một phần quy tắc mà không kết hợp được các bước còn lại, kết quả cuối cùng vẫn có thể không chính xác. Đây là dạng thử thách liên quan đến compositional reasoning, tức khả năng kết hợp các quy tắc để giải quyết vấn đề phức tạp hơn.
3. Cùng một quy tắc có thể cần áp dụng khác nhau theo ngữ cảnh
Trong một số bài toán, quy tắc không thể được áp dụng máy móc cho mọi đối tượng. Cách biến đổi phụ thuộc vào vị trí, mối quan hệ hoặc điều kiện xuất hiện trong từng lưới. Điều này khiến việc nhận diện một mẫu hình đơn giản không đủ để tìm ra đáp án. AI phải xác định yếu tố nào quyết định cách áp dụng quy tắc trong trường hợp cụ thể.
4. Điểm số cần được xem cùng chi phí tính toán
Một hệ thống có thể cải thiện độ chính xác bằng cách dành nhiều thời gian, sử dụng nhiều lượt suy luận hoặc tăng tài nguyên tính toán. Tuy nhiên, kết quả cao hơn không nhất thiết đồng nghĩa với phương pháp hiệu quả hơn.
Vì vậy, ARC-AGI-2 còn hướng đến việc đo lường chi phí để giải quyết vấn đề. Đây là góc nhìn hữu ích khi so sánh các mô hình AI: ngoài độ chính xác, người đánh giá cần xem hệ thống tiêu tốn bao nhiêu tài nguyên để đạt được kết quả đó.
ARC-AGI-2 khác ARC-AGI-1 như thế nào?
ARC-AGI-1 là phiên bản đầu tiên của Abstraction and Reasoning Corpus, được giới thiệu năm 2019. ARC-AGI-2 tiếp nối hướng đánh giá này nhưng tăng độ khó của các bài toán và nhấn mạnh hơn vào hiệu quả tính toán.
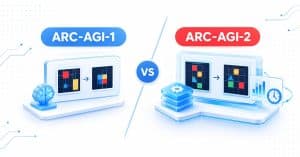
| Tiêu chí | ARC-AGI-1 | ARC-AGI-2 |
| Mục tiêu | Đánh giá khả năng suy luận trừu tượng và khái quát hóa | Tiếp tục đánh giá các năng lực trên với những thử thách khó hơn |
| Dạng bài | Bài toán biến đổi lưới đầu vào – đầu ra | Duy trì dạng bài lưới nhưng tăng yêu cầu về suy luận |
| Trọng tâm | Tìm quy luật và áp dụng vào dữ liệu mới | Diễn giải ký hiệu, kết hợp quy tắc, áp dụng theo ngữ cảnh |
| Thiết kế tập đánh giá | Phiên bản ban đầu | Loại bỏ các bài có thể giải bằng tìm kiếm vét cạn theo thiết kế của phiên bản mới |
| Hiệu quả tính toán | Không phải trọng tâm được công bố rõ như phiên bản mới | Được đưa vào đánh giá cùng khả năng giải bài toán |
Có thể hiểu đơn giản rằng ARC-AGI-2 không chỉ tiếp tục hỏi AI “có tìm ra đáp án không?”, mà còn đặt ra thử thách sâu hơn về cách hệ thống tìm ra quy luật và mức tài nguyên cần thiết để giải bài toán.
Tuy nhiên, không nên kết luận rằng mọi điểm số ARC-AGI-1 đều có thể so sánh trực tiếp với ARC-AGI-2. Hai phiên bản có cấu trúc đánh giá và độ khó khác nhau, vì vậy cần sử dụng kết quả đúng benchmark và đúng điều kiện thử nghiệm.
Gemini đạt kết quả như thế nào trên ARC-AGI-2?
ARC-AGI-2 là một trong những benchmark được sử dụng để đánh giá năng lực suy luận của các mô hình AI tiên tiến, trong đó có Google Gemini. Kết quả của Gemini cho thấy sự khác biệt đáng kể giữa các phiên bản mô hình và cấu hình suy luận.
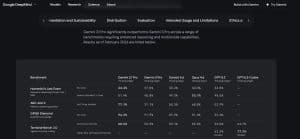
Theo model card do Google DeepMind công bố ngày 19/02/2026, Gemini 3.1 Pro Thinking (High) đạt 77,1% trên ARC-AGI-2, trong khi Gemini 3 Pro Thinking (High) đạt 31,1%. Đây là kết quả được ghi nhận trong bảng đánh giá của Google DeepMind tại thời điểm công bố.
| Mô hình | Cấu hình được công bố | Điểm ARC-AGI-2 |
| Gemini 3.1 Pro | Thinking (High) | 77,1% |
| Gemini 3 Pro | Thinking (High) | 31,1% |
Theo bảng số liệu trên, Gemini 3.1 Pro Thinking (High) cao hơn Gemini 3 Pro Thinking (High) 46 điểm phần trăm trên ARC-AGI-2. Đây là mức chênh lệch đáng chú ý trong bài đánh giá suy luận trừu tượng.
Kết quả này cho thấy phiên bản Gemini 3.1 Pro có bước cải thiện lớn trên benchmark cụ thể. Tuy nhiên, chúng ta không nên diễn giải rằng mô hình đã trở nên tốt hơn 46% trong mọi tác vụ AI, bởi mức chênh lệch chỉ phản ánh điểm số trên ARC-AGI-2 trong điều kiện đánh giá được công bố.
Khi so sánh mô hình, bạn nên xem đồng thời benchmark, cấu hình suy luận, phương pháp đánh giá và thời điểm công bố. Những yếu tố này giúp tránh việc đối chiếu các con số được đo bằng những điều kiện khác nhau.
Đăng ký trải nghiệm Google Gemini tại Gemini.vn
Theo công bố của Google DeepMind vào tháng 2/2026, Gemini 3.1 Pro Thinking (High) đạt 77,1% trên ARC-AGI-2, với kết quả được ARC Prize xác minh. Con số này cao hơn đáng kể so với mức 31,1% của Gemini 3 Pro Thinking (High), cho thấy bước tiến rõ rệt về khả năng suy luận trừu tượng và giải quyết vấn đề mới của Gemini.
Những cải thiện về năng lực suy luận mở ra nhiều tiềm năng ứng dụng Google Gemini trong học tập và công việc hằng ngày:
- Học tập và nghiên cứu: Giải thích kiến thức, tổng hợp tài liệu, gợi ý hướng nghiên cứu và hệ thống hóa thông tin.
- Sáng tạo nội dung: Phát triển ý tưởng, xây dựng dàn bài, viết và chỉnh sửa nội dung.
- Phân tích dữ liệu: Hỗ trợ đọc hiểu tài liệu, tổng hợp thông tin và nhận diện những điểm đáng chú ý.
- Tối ưu công việc: Hỗ trợ soạn thảo văn bản, lập kế hoạch và xử lý các tác vụ thường ngày.
Với những năng lực ngày càng được cải thiện, Google Gemini là một lựa chọn đáng trải nghiệm để hỗ trợ nâng cao hiệu suất học tập và làm việc. Tại Gemini.vn thuộc HVN Group, bạn có thể tìm hiểu các giải pháp Google Gemini phù hợp với nhu cầu cá nhân hoặc doanh nghiệp. Liên hệ tư vấn để được hỗ trợ lựa chọn phương án sử dụng và triển khai phù hợp.
Câu hỏi thường gặp về ARC-AGI-2
- ARC-AGI-2 là gì?
ARC-AGI-2 là benchmark do ARC Prize Foundation phát triển để đánh giá khả năng suy luận trừu tượng và khái quát hóa quy luật của AI thông qua các bài toán dạng lưới hình ảnh.
- ARC-AGI-2 có bao nhiêu bài toán?
ARC-AGI-2 có tổng cộng 1.360 bài toán, gồm 1.000 bài trong tập huấn luyện và 360 bài thuộc ba tập đánh giá: public, semi-private và private, mỗi tập có 120 bài.
- ARC-AGI-2 khác ARC-AGI-1 như thế nào?
ARC-AGI-2 là phiên bản tiếp theo với các bài toán được thiết kế khó hơn, tập trung vào diễn giải ký hiệu, kết hợp nhiều quy tắc, áp dụng quy tắc theo ngữ cảnh và hiệu quả tính toán.
- Điểm cao trên ARC-AGI-2 có chứng minh AI đã đạt AGI không?
Không. Điểm cao thể hiện năng lực tốt trong phạm vi benchmark, nhưng không đủ để chứng minh AI đã đạt trí tuệ nhân tạo tổng quát. Cần đánh giá thêm nhiều năng lực và điều kiện sử dụng khác nhau.
Kết luận
ARC-AGI-2 là benchmark đánh giá khả năng suy luận trừu tượng, nhận diện quy luật và khái quát hóa của AI thông qua 1.360 bài toán với phương pháp chấm điểm pass@2. Kết quả Gemini 3.1 Pro đạt 77,1% vào tháng 2/2026 cho thấy bước cải thiện đáng kể so với Gemini 3 Pro, nhưng cần kết hợp nhiều tiêu chí để đánh giá toàn diện năng lực AI.
Nếu doanh nghiệp đang tìm hiểu cách ứng dụng Google AI vào quy trình làm việc, Gemini.vn thuộc HVN Group là kênh tham khảo các giải pháp trong hệ sinh thái Google. Bạn có thể truy cập Gemini.vn hoặc liên hệ hotline 024.9999.7777 để tìm hiểu thêm về các phương án ứng dụng Google Gemini trong công việc và quy trình doanh nghiệp.
