Nói một cách dễ hiểu, kiến trúc Sparse Mixture-of-Experts (MoE) chính là ‘bí thuật’ đằng sau sức mạnh của các dòng Gemini, từ các bản 1.5, 2.5 cho tới những bước tiến mới như Gemini 3 và 3.1 Pro. Công nghệ này giúp mô hình xử lý lượng dữ liệu ngữ cảnh khổng lồ cực kỳ nhanh mượt, mà vẫn tiết kiệm đáng kể tài nguyên tính toán.
Bài viết dưới đây từ Gemini.vn sẽ phân tích chi tiết Sparse Mixture-of-Experts (SMoE), kiến trúc ‘bí thuật’ đằng sau sức mạnh của các dòng Gemini (từ 1.5, 2.5 cho tới Gemini 3 và 3.1 Pro). Công nghệ này giúp mô hình phân luồng dữ liệu thông minh, xử lý lượng ngữ cảnh khổng lồ cực kỳ nhanh mượt mà vẫn tiết kiệm đến 85% tài nguyên tính toán cho doanh nghiệp!
Sparse Mixture-of-Experts của Gemini là gì?
Sparse Mixture-of-Experts (SMoE) là kiến trúc mạng nơ-ron phân nhánh nâng cao trong Google Gemini, cho phép thay thế các tầng Feed-Forward Network truyền thống bằng một tập hợp các mạng chuyên gia (Experts) độc lập và sử dụng cơ chế định tuyến thông minh (Router) để chỉ kích hoạt một phần nhỏ tham số cho mỗi token dữ liệu.
Để hiểu nguyên lý đột phá của kiến trúc này, cần phân biệt sự khác nhau giữa hai mô hình học máy:
- Mô hình dày đặc (Dense Model): Là mô hình mà trong đó tất cả các tham số (parameters) đều tham gia vào quá trình tính toán cho mọi từ hoặc token đầu vào. Ví dụ, nếu một mô hình Dense có 100 tỷ tham số, thì với mỗi từ nhập vào, hệ thống phải thực hiện phép tính ma trận trên toàn bộ 100 tỷ tham số đó. Điều này tạo ra gánh nặng tính toán rất lớn, làm tăng độ trễ phản hồi và chi phí năng lượng của trung tâm dữ liệu.
- Mô hình thưa (Sparse Model – SMoE): Thay vì duy trì một khối ma trận khổng lồ duy nhất, kiến trúc này chia tầng tính toán Feed-Forward Network thành N mạng chuyên gia nhỏ hơn (mỗi chuyên gia đóng vai trò như một mạng nơ-ron chuyên biệt). Đi kèm với đó là một mạng định tuyến (Gating Network hoặc Router). Khi nhận dữ liệu đầu vào, Router chỉ tính toán và chọn ra K chuyên gia phù hợp nhất (KN, thường chọn K=1 hoặc K=2). Nhờ vậy, tổng dung lượng tri thức lưu trữ của mô hình có thể lên tới hàng trăm tỷ tham số, nhưng lượng tham số thực sự chạy cho mỗi token chỉ chiếm khoảng 10% – 15%.
Kiến trúc Sparse Mixture-of-Experts tạo ra bước tiến nền tảng cho Google Gemini:
- Bứt phá giới hạn về quy mô tri thức: Cho phép bổ sung thêm hàng chục chuyên gia mới vào mô hình để mở rộng khả năng đọc hiểu đa lĩnh vực mà không làm tăng khối lượng phép tính trên từng dòng lệnh.
- Tối ưu hóa chỉ số FLOPs per Token: Giảm số lượng phép tính số thực (Floating Point Operations) cần thiết cho mỗi token đầu ra, giúp giảm mức tiêu thụ điện năng trên các hệ thống phần cứng Google TPU.
- Tốc độ phản hồi cực nhanh: Giữ cho thời gian suy luận (Inference Latency) ở mức thấp, giúp các phiên bản Gemini như Gemini Flash hay Gemini Pro phản hồi câu hỏi của người dùng chỉ trong vài mili-giây.
4 bước vận hành của kiến trúc Sparse Mixture-of-Experts trong Gemini
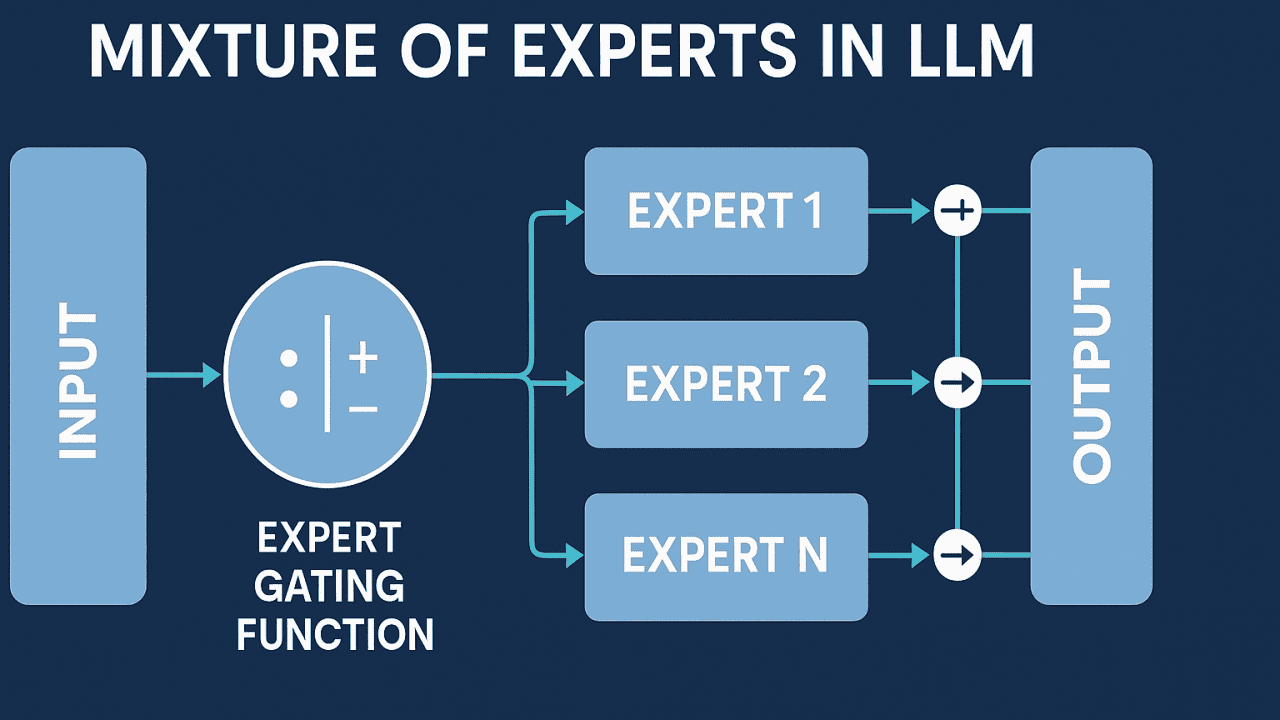
Cơ chế vận hành của Sparse Mixture-of-Experts trong Gemini dựa trên chu trình tiếp nhận token, định tuyến qua Gating Network, kích hoạt chuyên gia chuyên biệt và tổng hợp trọng số đầu ra cực nhanh.
Sơ đồ quy trình luồng xử lý dữ liệu qua mạng định tuyến và các chuyên gia:
- Bước 1: Tiếp nhận vector token đầu vào
Dữ liệu chữ, hình ảnh hoặc âm thanh sau khi đi qua các tầng chú ý tự thân (Self-Attention Layer) sẽ được mã hóa thành các chuỗi vector biểu diễn đa chiều. Chuỗi vector này sau đó được chuyển đến tầng Sparse Mixture-of-Experts để xử lý ngữ nghĩa chuyên sâu.
- Bước 2: Định tuyến thông minh bằng Gating Network (Router)
Tại tầng SMoE, mạng Router (Gating Network) sẽ nhân vector đầu vào x với ma trận trọng số Wg để tính toán phân phối xác suất Softmax cho tất cả các chuyên gia:
Gating(x)=Softmax(TopK(xWg,K))
Thuật toán Top-K Routing sẽ tự động chọn ra K chuyên gia có điểm số cao nhất (ví dụ: Top-2). Tất cả các chuyên gia còn lại sẽ có trọng số bằng 0 và hoàn toàn nằm ở trạng thái nghỉ, không tiêu tốn tài nguyên phần cứng.
- Bước 3: Xử lý song song tại các chuyên gia được kích hoạt
Vector token x chỉ được gửi đến K chuyên gia đã được chọn. Mỗi chuyên gia thực chất là một mạng Feed-Forward Network (FFN) sở hữu ma trận trọng số riêng, được tối ưu hóa để xử lý các dạng cấu trúc dữ liệu cụ thể (như cú pháp lập trình Python, công thức toán học, hoặc ngữ pháp ngôn ngữ). Quá trình tính toán tại các chuyên gia được chọn diễn ra song song với tốc độ tối đa trên chip xử lý TPU.
- Bước 4: Tổng hợp kết quả và cân bằng tải (Auxiliary Loss & Load Balancing)
Đầu ra từ các chuyên gia được nhân với điểm số trọng số tương ứng do Router phân bổ, sau đó cộng lại để tạo thành vector kết quả cuối cùng:
y=i=1KGating(x)iEi(x)
Để tránh hiện tượng “định kiến Router” (khi một vài chuyên gia liên tục bị chọn dẫn đến quá tải, trong khi các chuyên gia khác bị bỏ trống), Google tích hợp thêm hàm mất mát phụ (Auxiliary Load Balancing Loss). Hàm này ép Router phân bổ đều dữ liệu cho tất cả các chuyên gia trong suốt quá trình huấn luyện, đảm bảo hệ thống luôn vận hành cân bằng và đạt hiệu năng tối ưu.
Tác động của Sparse Mixture-of-Experts lên Gemini AI
Tích hợp kiến trúc Sparse Mixture-of-Experts tạo ra bước ngoặt lớn, giúp Google Gemini tối ưu hóa tỷ lệ hiệu năng trên chi phí (Performance-to-Cost) và duy trì lợi thế cạnh tranh trong các dòng mô hình Flash và Pro.
Kiến trúc thưa mang lại những giá trị chiến lược vượt trội cho hạ tầng AI của Google:
- Chuyên môn hóa sâu theo từng lĩnh vực (Domain Specialization): Khi huấn luyện mô hình, các chuyên gia tự động tích lũy các mảng tri thức chuyên biệt. Một chuyên gia có thể giỏi về xử lý các cấu trúc mã code, trong khi chuyên gia khác tập trung vào lập luận logic toán học. Điều này ngăn chặn hiện tượng can thiệp trọng số (Catastrophic Interference) – nơi việc học kiến thức mới làm suy giảm kiến thức cũ.
- Tối ưu hóa chi phí gọi API và duy trì dịch vụ: Nhờ giảm được 80% – 90% lượng tham số kích hoạt thực tế cho mỗi lượt truy vấn, Google giảm bớt chi phí điện năng và máy chủ, từ đó cung cấp mức giá API Gemini cực kỳ cạnh tranh cho doanh nghiệp.
Bảng so sánh giữa Mô hình Dense và Kiến trúc Sparse Mixture-of-Experts
Dưới đây là bảng so sánh trực quan giữa mô hình AI truyền thống dạng Dense và kiến trúc Sparse Mixture-of-Experts trong Gemini:
| Tiêu chí so sánh | Mô hình Dense (Dày đặc) | Kiến trúc Sparse Mixture-of-Experts (SMoE) |
| Số tham số kích hoạt/token | 100% tổng số tham số của mô hình | Chỉ khoảng 10% – 15% số tham số (Top-K) |
| Tổng dung lượng tri thức | Bị giới hạn bởi khả năng tính toán của phần cứng | Mở rộng khổng lồ bằng cách bổ sung thêm Chuyên gia |
| Chi phí tính toán (FLOPs) | Rất cao, tăng mạnh khi mô hình mở rộng | Tối ưu, thấp hơn nhiều so với tổng dung lượng tham số |
| Tốc độ suy luận (Inference) | Chậm dần khi quy mô mô hình tăng lên | Cực nhanh nhờ chỉ tính toán trên số ít chuyên gia chọn lọc |
| Chuyên môn hóa tác vụ | Dùng chung 1 mạng ma trận cho mọi bài toán | Mỗi chuyên gia giải quyết các dạng bài toán chuyên biệt |
Việc tích hợp kiến trúc Sparse Mixture-of-Experts (SMoE) là một bước tiến chiến lược giúp Google Gemini bứt phá khỏi những giới hạn của mô hình Dense truyền thống. Bằng cơ chế phân luồng thông minh chỉ kích hoạt luồng dữ liệu đến các chuyên gia phù hợp, SMoE mang lại khả năng mở rộng tri thức khổng lồ, tốc độ suy luận cực nhanh và khả năng chuyên môn hóa sâu cho từng tác vụ. Sự đột phá công nghệ này không chỉ tối ưu hóa hiệu năng tính toán mà còn cắt giảm triệt để chi phí vận hành phần cứng, tạo nền tảng vững chắc để Google cung cấp các mô hình AI mạnh mẽ với mức giá API cạnh tranh hàng đầu trên thị trường.
Sparse Mixture-of-Experts ứng dụng trong vận hành doanh nghiệp
Ứng dụng kiến trúc Sparse Mixture-of-Experts giúp doanh nghiệp vận hành hệ thống AI đa nhiệm với độ chính xác cao và tốc độ xử lý vượt trội. 4 kịch bản ứng dụng mang lại hiệu quả cao nhất bao gồm: Xử lý dịch vụ khách hàng đa ngôn ngữ, hỗ trợ lập trình và kiểm thử phần mềm, phân tích dữ liệu đa phân phân khúc, và tự động hóa quy trình nghiệp vụ phức tạp.
Vận hành Trợ lý AI đa năng cho toàn doanh nghiệp
Trong cùng một tập đoàn, các phòng ban sử dụng AI cho những mục đích hoàn toàn khác biệt: Kế toán cần rà soát báo cáo tài chính, Lập trình viên cần kiểm thử mã nguồn, còn PR – Marketing lại cần viết bài truyền thông. Nếu dùng mô hình Dense truyền thống, toàn bộ hệ thống phải hoạt động để giải quyết từng câu hỏi đơn lẻ, gây lãng phí tài nguyên và phản hồi chung chung.
Cơ chế SMoE: Bộ định tuyến (Router) đóng vai trò như một “tổng đài viên” thông minh. Khi tiếp nhận yêu cầu, Router ngay lập tức phân tích và định hướng dữ liệu đến đúng nhóm “chuyên gia AI” đã được huấn luyện chuyên sâu cho lĩnh vực đó.
Hiệu quả thực tế:
- Giảm tối đa tình trạng phản hồi sai lệch hoặc thiếu tính chuyên môn.
- Tối ưu thời gian xử lý chỉ còn vài giây dù yêu cầu có độ phức tạp cao.
- Giúp doanh nghiệp dùng duy nhất một hệ thống AI để phục vụ toàn bộ bộ máy vận hành mà không lo quá tải.
Dịch thuật chuyên ngành và xử lý đa ngữ cảnh
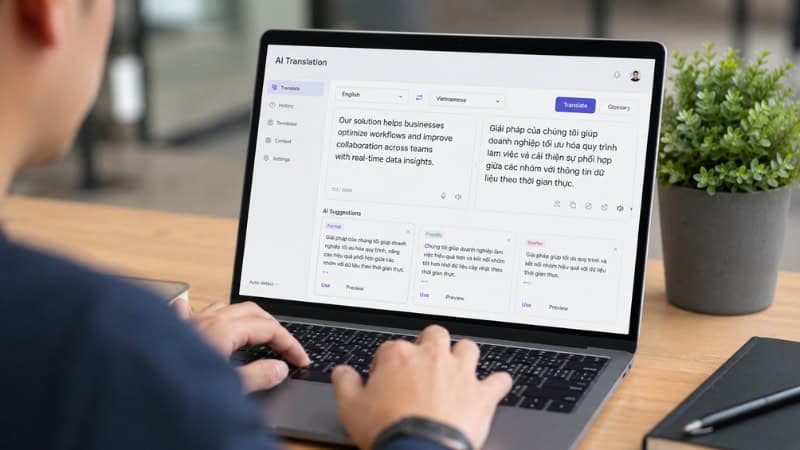
Dịch thuật trong doanh nghiệp không đơn thuần là chuyển đổi từ ngữ, mà đòi hỏi hiểu rõ thuật ngữ chuyên môn sâu (như hợp đồng pháp lý, tài liệu y khoa hay bản vẽ kỹ thuật). Các công cụ dịch thông thường dễ mắc lỗi dịch thô, sai ngữ cảnh hoặc mất văn phong chuyên nghiệp.
Cơ chế SMoE: SMoE kích hoạt đồng thời các cụm chuyên gia xử lý ngôn ngữ và chuyên gia am hiểu thuật ngữ ngành. Nhờ đó, AI vừa nắm bắt được ngữ pháp tổng thể, vừa tra cứu chính xác thuật ngữ chuyên biệt cho từng loại tài liệu.
Hiệu quả thực tế:
- Giữ nguyên bối cảnh và văn phong chuẩn mực của từng ngành (Pháp lý, Y tế, Kỹ thuật).
- Hỗ trợ xử lý tài liệu đa ngôn ngữ phức tạp với độ chính xác tiệm cận chuyên gia nhân sự.
- Tiết kiệm đáng kể thời gian biên dịch và hiệu đính tài liệu quốc tế cho doanh nghiệp.
Phân tích dữ liệu kinh doanh và lập luận logic tức thì
Ban lãnh đạo thường xuyên phải đối mặt với hàng loạt bảng tính khổng lồ, dữ liệu doanh thu, chi phí và báo cáo thị trường. Việc tổng hợp thủ công hay dùng các công cụ phân tích tĩnh tốn nhiều thời gian và khó đưa ra nhận định mang tính dự báo.
Cơ chế SMoE: Ngay khi nhận được tệp dữ liệu hoặc câu hỏi về số liệu, Router sẽ chuyển tiếp nhiệm vụ đến nhóm chuyên gia tính toán đại số và lập luận logic. Cụm chuyên gia này tập trung tối đa năng lượng tính toán để bóc tách con số mà không bị phân tán bởi các tác vụ xử lý ngôn ngữ khác.
Hiệu quả thực tế:
- Tự động tính toán các chỉ số tài chính (KPIs, ROI, biên lợi nhuận) chính xác tuyệt đối.
- Phát hiện xu hướng, bất thường trong dữ liệu và đưa ra gợi ý chiến lược trực quan.
- Hỗ trợ cấp quản lý ra quyết định kinh doanh nhanh chóng dựa trên dữ liệu thực (Data-driven).
Tối ưu hệ thống chăm sóc khách hàng (CSKH) quy mô lớn
Các tổng đài tự động hoặc Chatbot của doanh nghiệp lớn phải xử lý hàng trăm nghìn đến hàng triệu lượt tương tác mỗi ngày. Vào các khung giờ cao điểm, hệ thống truyền thống rất dễ rơi vào tình trạng giật lag, độ trễ phản hồi cao hoặc sập hạ tầng.
Cơ chế SMoE: Nhờ khả năng chỉ kích hoạt khoảng 10% – 15% tham số cho mỗi lượt truy vấn, chi phí tính toán (FLOPs) trên từng tin nhắn được giảm bớt từ 80% – 90%. Áp lực lên hệ thống máy chủ giảm đi rõ rệt.
Hiệu quả thực tế:
- Duy trì độ trễ phản hồi cực thấp (gần như tức thì), giữ luồng trò chuyện tự nhiên với khách hàng.
- Phục vụ song song hàng ngàn khách hàng cùng lúc mà không xảy ra hiện tượng nghẽn mạng.
- Cắt giảm đáng kể chi phí điện năng và hạ tầng phần cứng cho doanh nghiệp khi vận hành AI ở quy mô lớn.
Hướng dẫn ứng dụng hạ tầng triển khai Google Gemini cho doanh nghiệp
Doanh nghiệp có thể dễ dàng khai thác hiệu năng vượt trội của mô hình Gemini dựa trên kiến trúc Sparse Mixture-of-Experts thông qua hạ tầng Google Cloud với sự tư vấn chuyên sâu từ các đối tác hạ tầng chính thức.
Lộ trình tích hợp giải pháp AI cho doanh nghiệp bao gồm 3 bước chuẩn hóa:
- Lựa chọn dòng mô hình Gemini phù hợp: Dựa vào mục tiêu vận hành để lựa chọn phiên bản mô hình tối ưu. Dòng Gemini Flash tận dụng triệt để kiến trúc SMoE mang lại tốc độ phản hồi cực nhanh với chi phí thấp, thích hợp cho các ứng dụng chăm sóc khách hàng. Dòng Gemini Pro phù hợp cho các tác vụ phân tích chuyên sâu.
- Cấu hình kết nối API bảo mật trên Google Cloud Vertex AI: Thiết lập cổng kết nối an toàn, phân quyền truy cập theo từng phòng ban và tích hợp vào các phần mềm quản trị nội bộ (CRM, ERP).
- Đồng hành cùng đối tác triển khai uy tín: Doanh nghiệp muốn chuẩn hóa hạ tầng đám mây, tối ưu hóa chi phí sử dụng bản quyền chính hãng và nhận tư vấn kỹ thuật bài bản có thể phối hợp cùng các đối tác phân phối chính thức của Google Cloud tại Việt Nam để đảm bảo hệ thống vận hành an toàn và trơn tru.
Để khai thác tối đa sức mạnh xử lý và tốc độ vượt trội của Gemini, việc trang bị gói dịch vụ bản quyền doanh nghiệp chính hãng là giải pháp tối ưu. Bạn có thể tham khảo bảng giá chi tiết và nhận tư vấn chuyên sâu từ đội ngũ chuyên gia ngay tại đây.
Các câu hỏi thường gặp (FAQ)
Giải đáp trực tiếp các thắc mắc kỹ thuật phổ biến giúp bạn hiểu rõ bản chất và lợi ích của kiến trúc Sparse Mixture-of-Experts.
Sparse Mixture-of-Experts khác gì so với mô hình AI Dense truyền thống?
Mô hình Dense kích hoạt 100% các tham số cho mọi câu hỏi đầu vào. Trong khi đó, Sparse Mixture-of-Experts sử dụng mạng Router để chỉ kích hoạt nhóm chuyên gia phù hợp (10% – 15% tham số), giúp tăng tốc độ xử lý và tiết kiệm đáng kể tài nguyên phần cứng.
Làm thế nào Router xác định được chuyên gia phù hợp cho từng từ đầu vào?
Mạng Router sử dụng hàm Softmax Gating được huấn luyện đồng thời với mô hình. Hàm này tính toán điểm số tương quan giữa vector đại diện của từ với các chuyên gia, sau đó chọn ra Top-K chuyên gia có điểm số cao nhất.
Mở rộng số lượng Chuyên gia có khiến mô hình bị chậm đi không?
Không. Việc bổ sung thêm các chuyên gia chỉ làm tăng dung lượng lưu trữ bộ nhớ (VRAM) của mô hình, nhưng không làm tăng số phép tính trên mỗi từ. Tốc độ suy luận vẫn diễn ra cực nhanh vì số lượng chuyên gia được kích hoạt cho từng từ luôn được giữ cố định.
Lập trình viên có cần chọn thủ công các Chuyên gia khi gọi API Gemini không?
Không. Quy trình phân rã dữ liệu, định tuyến qua Router và tổng hợp kết quả của các Chuyên gia được tự động hóa hoàn toàn ở cấp độ hạ tầng mô hình trên Google Cloud.
Doanh nghiệp có thể nhận tư vấn và đăng ký bản quyền giải pháp Google AI ở đâu?
Doanh nghiệp có thể đăng ký dịch vụ và nhận tư vấn trực tiếp qua kênh chính thức của Google Cloud hoặc các nhà phân phối ủy quyền tại Việt Nam để nhận sự hỗ trợ kỹ thuật và triển khai dự án cực nhanh.
Tổng kết
Kiến trúc Sparse Mixture-of-Experts là giải pháp công nghệ mang tính cách mạng giúp Google mở rộng quy mô tri thức của Gemini lên tầm cao mới. Bằng việc kết hợp giữa khả năng chuyên môn hóa của các mạng chuyên gia và cơ chế định tuyến thông minh, SMoE mang lại hiệu năng xử lý ấn tượng với chi phí vận hành tối ưu, giúp doanh nghiệp bứt phá hiệu suất công việc trong kỷ nguyên AI.
Để trải nghiệm phiên bản Gemini AI mới nhất, quý khách vui lòng liên hệ Gemini.vn hoặc qua hotline 024.9999.7777 để được tư vấn và hỗ trợ nhanh nhất.
