AI đạt điểm cao trong các bài đánh giá khó có đồng nghĩa với việc mô hình sở hữu năng lực suy luận chuyên sâu? Humanity’s Last Exam (HLE) là benchmark gồm 2.500 câu hỏi học thuật thuộc hơn 100 lĩnh vực, được thiết kế để thử thách giới hạn của các mô hình AI. Bài viết sẽ giải thích cách HLE được xây dựng, phương pháp chấm điểm, ý nghĩa của kết quả và cách đặt benchmark này bên cạnh MMLU, GPQA để hiểu rõ hơn năng lực của các mô hình AI.
Humanity’s Last Exam là gì?
Humanity’s Last Exam là bộ benchmark đa phương thức gồm 2.500 câu hỏi học thuật khó, được xây dựng nhằm đánh giá năng lực của các mô hình ngôn ngữ lớn (LLM) ở những lĩnh vực đòi hỏi kiến thức chuyên sâu và khả năng suy luận. HLE được phát triển thông qua sự hợp tác giữa Center for AI Safety (CAIS), Scale AI và cộng đồng chuyên gia đóng góp câu hỏi.
Theo trang HLE chính thức, bộ dữ liệu bao phủ hơn 100 lĩnh vực, từ toán học, vật lý, hóa học, sinh học đến y học, khoa học máy tính và nhân văn. Điểm đáng chú ý là HLE không chỉ kiểm tra khả năng ghi nhớ kiến thức phổ thông mà tập trung vào các câu hỏi khó, có đáp án xác định và có thể kiểm chứng.
Các benchmark AI phổ biến dần khó phân biệt năng lực giữa những mô hình tiên tiến khi chúng đạt điểm cao trên các bộ đánh giá như MMLU. Điều này thúc đẩy nhu cầu xây dựng một benchmark khó hơn, tập trung vào những câu hỏi học thuật chuyên sâu và đòi hỏi khả năng suy luận. Humanity’s Last Exam ra đời nhằm đáp ứng mục tiêu đó, nhưng điểm số trên benchmark vẫn chỉ phản ánh hiệu suất trong phạm vi đánh giá cụ thể, không chứng minh AI vượt trội con người trong mọi lĩnh vực.
HLE được xây dựng và chấm điểm như thế nào?
Để hiểu rõ Humanity’s Last Exam là gì và benchmark này đánh giá năng lực AI ra sao, cần xem xét ba yếu tố: cách tuyển chọn câu hỏi, các dạng bài kiểm tra và phương pháp chấm điểm. Những yếu tố này giúp làm rõ cách HLE đo lường năng lực của mô hình, đồng thời giúp người đọc diễn giải kết quả trên bảng xếp hạng chính xác hơn.
Câu hỏi HLE được tuyển chọn như thế nào?
HLE là dự án cộng tác quốc tế với gần 1.000 chuyên gia đóng góp câu hỏi, đến từ hơn 500 tổ chức tại 50 quốc gia. Theo thông tin trên bảng xếp hạng chính thức của Scale AI, dự án nhận được hơn 70.000 câu hỏi gửi về, trong đó khoảng 13.000 câu vượt qua vòng sàng lọc độ khó để chuyển sang quy trình đánh giá của con người.
Quy trình xây dựng bộ dữ liệu gồm các bước chính:
- Tiếp nhận câu hỏi: Chuyên gia đề xuất những vấn đề thuộc lĩnh vực chuyên môn của mình, với đáp án rõ ràng và có thể kiểm chứng.
- Sàng lọc độ khó: Các câu hỏi được kiểm tra bằng mô hình AI và tiêu chí đánh giá để loại những câu chưa đủ thách thức.
- Thẩm định chuyên môn: Người đánh giá có chuyên môn phù hợp xem xét chất lượng, tính chính xác và mức độ rõ ràng của câu hỏi.
- Hoàn thiện bộ dữ liệu: Các câu hỏi được lựa chọn tiếp tục trải qua quá trình kiểm tra và điều chỉnh dựa trên phản hồi.
Ngày 03/04/2025, Scale AI công bố Humanity’s Last Exam (HLE) đã được hoàn thiện với 2.500 câu hỏi công khai. Ngoài bộ câu hỏi công khai, dự án còn duy trì tập câu hỏi riêng không công khai để hỗ trợ nghiên cứu nguy cơ mô hình ghi nhớ dữ liệu benchmark hoặc tối ưu hóa quá mức cho một bộ đề cố định.
HLE gồm những dạng câu hỏi nào?
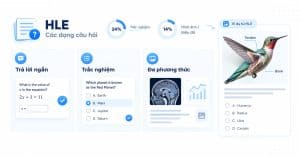
HLE kết hợp câu hỏi văn bản với những bài yêu cầu mô hình xử lý hình ảnh, biểu đồ hoặc sơ đồ. Theo Scale AI, 24% câu hỏi trong bộ HLE gốc là trắc nghiệm và 14% yêu cầu hiểu nội dung hình ảnh. Các định dạng này giúp đánh giá nhiều năng lực khác nhau, từ kiến thức chuyên ngành đến suy luận nhiều bước và diễn giải dữ liệu trực quan.
Các câu hỏi chủ yếu thuộc những dạng sau:
- Câu hỏi trả lời ngắn: Mô hình cần đưa ra đáp án cụ thể, chẳng hạn một con số, thuật ngữ hoặc kết quả chuyên môn.
- Câu hỏi trắc nghiệm: Mô hình lựa chọn đáp án phù hợp trong số các phương án được cung cấp.
- Câu hỏi đa phương thức: Mô hình phải kết hợp nội dung văn bản với hình ảnh, biểu đồ hoặc sơ đồ để giải quyết vấn đề.
Những dạng câu hỏi này đòi hỏi các năng lực khác nhau, từ kiến thức chuyên ngành đến suy luận nhiều bước và diễn giải dữ liệu trực quan.
Ví dụ, trang HLE chính thức có câu hỏi thuộc lĩnh vực sinh thái học về cấu trúc giải phẫu của chim ruồi, yêu cầu xác định một thông tin chuyên biệt liên quan đến gân và xương. Ví dụ này cho thấy HLE không chỉ kiểm tra khả năng trả lời những câu hỏi phổ thông mà còn đưa ra các vấn đề đòi hỏi kiến thức hẹp và chuyên sâu.
Điểm HLE được tính như thế nào?
Humanity’s Last Exam cos cách đọc điểm số gắn liền với hai chỉ số quan trọng là accuracy (độ chính xác) và RMS calibration error (sai số hiệu chỉnh độ tin cậy).
| Chỉ số | Ý nghĩa | Cách diễn giải |
| Accuracy | Tỷ lệ câu trả lời được chấm là đúng trên bộ câu hỏi được đánh giá | Điểm cao hơn cho thấy mô hình trả lời đúng nhiều câu hơn trong điều kiện kiểm tra tương ứng. |
| RMS calibration error | Đánh giá mức độ phù hợp giữa độ tự tin mà mô hình thể hiện và độ chính xác thực tế | Sai số thấp hơn thường cho thấy độ tự tin được hiệu chỉnh tốt hơn. |
Ví dụ, accuracy 40% nghĩa là mô hình trả lời đúng 40% số câu hỏi trong lượt đánh giá. Tuy nhiên, chỉ số này không phản ánh mức độ tự tin có tương xứng với độ chính xác hay không, nên calibration error được dùng để bổ sung thông tin về độ tin cậy của câu trả lời.
Theo leaderboard của Scale AI, mô hình được xếp hạng dựa trên accuracy, còn calibration error giúp đánh giá thêm mức độ hiệu chỉnh độ tin cậy. Khi so sánh kết quả, cần xét cả phiên bản mô hình, benchmark, cấu hình và điều kiện thử nghiệm.
Điểm Humanity’s Last Exam có ý nghĩa gì?
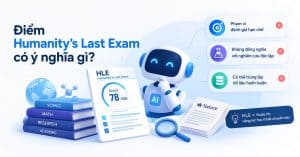
Điểm HLE phản ánh khả năng trả lời các câu hỏi học thuật chuyên sâu trong điều kiện đánh giá cụ thể, chứ không đại diện cho toàn bộ năng lực của mô hình AI. Điểm số cao cho thấy mô hình xử lý tốt hơn những câu hỏi thuộc phạm vi benchmark, nhưng không đủ để chứng minh AI có thể thực hiện nghiên cứu độc lập hoặc giải quyết hiệu quả mọi nhiệm vụ thực tế.
Điểm cao có thể cho thấy mô hình xử lý tốt các câu hỏi thuộc phạm vi benchmark, nhưng không chứng minh AI làm tốt mọi công việc, có khả năng nghiên cứu độc lập hay đã đạt trí tuệ nhân tạo tổng quát (AGI). Khi diễn giải kết quả, cần lưu ý ba giới hạn:
- Phạm vi đánh giá: HLE chưa bao quát toàn bộ nhiệm vụ trong đời sống và công việc.
- Năng lực nghiên cứu: Trả lời đúng câu hỏi khoa học không đồng nghĩa với khả năng tự đặt giả thuyết, thiết kế thí nghiệm và hoàn thành nghiên cứu độc lập.
- Nguy cơ ghi nhớ dữ liệu: Câu hỏi hoặc đáp án có thể đã xuất hiện trong dữ liệu huấn luyện, ảnh hưởng đến kết quả đánh giá.
Nghiên cứu về HLE đăng trên Nature cũng nhấn mạnh sự cần thiết phải thận trọng khi suy rộng kết quả benchmark thành kết luận về năng lực nghiên cứu tự chủ của AI. Vì vậy, HLE nên được xem là một thước đo chuyên sâu về năng lực học thuật, không phải tiêu chuẩn duy nhất để xác định mô hình AI thông minh nhất.
Cách đọc bảng xếp hạng Humanity’s Last Exam
Hiểu Humanity’s Last Exam là gì mới chỉ là bước đầu; để diễn giải kết quả đánh giá, người đọc còn cần biết cách đọc bảng xếp hạng HLE. Bảng này giúp theo dõi hiệu suất của các mô hình AI, nhưng cần phân biệt phiên bản benchmark, phiên bản mô hình và điều kiện thử nghiệm trước khi so sánh điểm số.
Phân biệt HLE, HLE-Rolling, HLE Preview và HLE Text Only
Khi tìm hiểu Humanity’s Last Exam là gì qua bảng xếp hạng, cần phân biệt HLE gốc với HLE-Rolling, HLE Preview và HLE Text Only. Mỗi phiên bản có đặc điểm riêng, ảnh hưởng đến cách diễn giải và so sánh điểm số.
| Phiên bản | Đặc điểm | Lưu ý khi đọc kết quả |
| HLE gốc | Bộ benchmark đã hoàn thiện với 2.500 câu hỏi công khai | Dùng làm phiên bản tham chiếu khi nói về cấu trúc HLE gốc. |
| HLE-Rolling | Nhánh được cập nhật liên tục, có điều chỉnh câu hỏi dựa trên phản hồi và tập câu hỏi giữ lại | Không mặc định so sánh trực tiếp điểm với HLE gốc như thể hai phiên bản dùng cùng một bộ đề. |
| HLE Preview | Phiên bản trước khi bộ HLE gốc được hoàn thiện, hiện được lưu trong mục phiên bản cũ của Scale AI | Cần phân biệt với bộ dữ liệu đã chốt 2.500 câu hỏi. |
| HLE Text Only | Biến thể đánh giá chỉ sử dụng câu hỏi dạng văn bản | Không đại diện đầy đủ cho khả năng xử lý hình ảnh của mô hình. |
Theo Scale AI, bản HLE gốc được hoàn thiện vào ngày 03/04/2025, còn HLE-Rolling có bản cập nhật được công bố ngày 17/09/2026.
Cần kiểm tra gì khi so sánh điểm HLE?
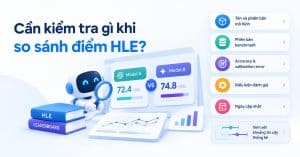
Khi đọc bảng xếp hạng HLE, cần xem xét tên và phiên bản mô hình, cấu hình đánh giá, phiên bản benchmark và thời điểm công bố kết quả. Những yếu tố này giúp xác định liệu các điểm số có thể so sánh trực tiếp hay chỉ phản ánh hiệu suất trong những điều kiện khác nhau.
- Tên và phiên bản mô hình: Hai kết quả có thể thuộc những phiên bản hoặc cấu hình suy luận khác nhau.
- Phiên bản benchmark: Cần xác định điểm số được đo trên HLE gốc, HLE-Rolling hay HLE Text Only.
- Accuracy và calibration error: Hai chỉ số phản ánh những khía cạnh khác nhau, không nên dùng thay thế cho nhau.
- Điều kiện đánh giá: Việc sử dụng công cụ, cấu hình suy luận và phương pháp thử nghiệm có thể ảnh hưởng đến kết quả.
- Ngày cập nhật: Leaderboard có thể thay đổi khi xuất hiện kết quả đánh giá mới.
Ngoài ra, khoảng tin cậy thống kê cũng cần được xem xét khi so sánh các mô hình có điểm số gần nhau. Nếu chênh lệch nhỏ và khoảng bất định còn đáng kể, không nên vội kết luận mô hình đứng trên chắc chắn vượt trội về năng lực.
Humanity’s Last Exam khác gì MMLU và GPQA?
HLE, MMLU và GPQA đều được sử dụng để đánh giá năng lực của mô hình AI, nhưng mỗi benchmark tập trung vào một khía cạnh khác nhau. So sánh mục tiêu, phạm vi kiến thức và định dạng câu hỏi sẽ giúp làm rõ benchmark nào phù hợp để đánh giá từng loại năng lực.
| Tiêu chí | Humanity’s Last Exam (HLE) | MMLU | GPQA |
| Mục tiêu chính | Đánh giá năng lực học thuật chuyên sâu trên nhiều lĩnh vực | Đánh giá kiến thức và khả năng giải quyết câu hỏi trong nhiều lĩnh vực học thuật | Đánh giá khả năng trả lời các câu hỏi khoa học khó ở cấp độ chuyên gia |
| Phạm vi | Hơn 100 lĩnh vực, có câu hỏi văn bản và đa phương thức | Nhiều lĩnh vực như toán học, khoa học, nhân văn và chuyên ngành | Tập trung vào các lĩnh vực khoa học như sinh học, vật lý và hóa học |
| Định dạng | Trả lời ngắn, trắc nghiệm và câu hỏi có hình ảnh | Chủ yếu là câu hỏi trắc nghiệm | Câu hỏi trắc nghiệm khoa học khó |
| Giá trị sử dụng | Theo dõi giới hạn năng lực học thuật của các mô hình tiên tiến | Đánh giá kiến thức trên phạm vi lĩnh vực rộng | Kiểm tra năng lực trả lời câu hỏi khoa học chuyên sâu |
MMLU đánh giá kiến thức trên nhiều lĩnh vực, GPQA tập trung vào các câu hỏi khoa học khó, còn HLE hướng đến những vấn đề học thuật chuyên sâu và có cả câu hỏi đa phương thức. Do khác biệt về dữ liệu, định dạng và mục tiêu, điểm số giữa ba benchmark không thể so sánh trực tiếp như thể chúng dùng chung một thang đo.
Nếu doanh nghiệp muốn ứng dụng Google Gemini hiệu quả hơn vào công việc, Gemini.vn thuộc HVN Group là kênh tham khảo các hướng dẫn sử dụng, thông tin cập nhật và giải pháp Gemini phù hợp với nhu cầu thực tế. Tùy mục tiêu triển khai, bạn có thể tìm hiểu các lựa chọn sử dụng và chi phí trước khi quyết định.
Gemini đạt kết quả như thế nào trên Humanity’s Last Exam?
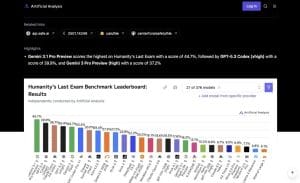
Trên bảng xếp hạng Humanity’s Last Exam (HLE) của Scale AI, Gemini đã chứng minh năng lực ấn tượng trong việc xử lý các bài toán học thuật đa lĩnh vực có độ khó cực cao. Nổi bật nhất, phiên bản Gemini 3.1 Pro Preview (chế độ thinking high) đạt độ chính xác 46,44% – cao hơn gần 9 điểm phần trăm so với thế hệ tiền nhiệm.
Dù HLE không đánh giá theo tiêu chí đỗ hay trượt, việc giải quyết đúng gần một nửa số câu hỏi siêu khó này là một minh chứng rõ nét cho khả năng suy luận chuyên sâu của Gemini, đồng thời thiết lập một cột mốc quan trọng để đối chiếu năng lực AI trong các tác vụ nghiên cứu phức tạp.
Kết quả của Gemini trên bảng xếp hạng HLE
Theo bảng xếp hạng Humanity’s Last Exam của Scale AI, Gemini 3.1 Pro Preview (thinking high) đạt accuracy 46,44%, với khoảng sai số ± 1,96 điểm phần trăm. Trong cùng bảng xếp hạng, Gemini 3 Pro Preview đạt 37,52%. Chênh lệch giữa hai kết quả là 8,92 điểm phần trăm, cho thấy Gemini 3.1 Pro Preview có kết quả cao hơn trong cấu hình đánh giá được công bố.
Điểm số HLE phản ánh điều gì về Gemini?
Accuracy 46,44% có nghĩa là mô hình trả lời đúng khoảng 46 trong mỗi 100 câu hỏi theo cách chấm điểm của benchmark. Đây là kết quả đáng chú ý trong một bài đánh giá tập trung vào các câu hỏi học thuật có độ khó cao, bao phủ nhiều lĩnh vực và kết hợp cả nội dung văn bản lẫn hình ảnh.
Tuy nhiên, điểm số này không có nghĩa Gemini đã vượt qua HLE theo tiêu chí đỗ – trượt. Benchmark không đưa ra một ngưỡng điểm chung để xác nhận mô hình đạt trình độ chuyên gia. Kết quả accuracy chủ yếu phản ánh tỷ lệ câu trả lời đúng trên tập câu hỏi được sử dụng để đánh giá, qua đó cung cấp thêm căn cứ để nghiên cứu khả năng xử lý những vấn đề học thuật phức tạp của mô hình.
Những lưu ý khi đánh giá kết quả của Gemini
Khi tham khảo kết quả HLE, cần đặt điểm số trong đúng bối cảnh đánh giá thay vì xem đây là thước đo toàn diện cho mọi năng lực của Gemini. Một số những yếu tố quan trọng cần lưu ý bao gồm:
- Phiên bản và cấu hình mô hình: Kết quả của Gemini 3.1 Pro Preview ở chế độ thinking high không đại diện cho tất cả phiên bản Gemini hoặc mọi cấu hình sử dụng.
- Phạm vi đánh giá: HLE tập trung vào các câu hỏi học thuật khó, nên điểm số không trực tiếp cho biết hiệu quả của mô hình trong mọi công việc thực tế.
- Chỉ số đánh giá: Scale AI sử dụng accuracy để xếp hạng, đồng thời công bố calibration error nhằm xem xét mức độ phù hợp giữa độ tự tin của mô hình và độ chính xác thực tế.
- Thời điểm công bố: Bảng xếp hạng có thể thay đổi khi có kết quả mới. Vì vậy, cần kiểm tra nguồn chính thức tại thời điểm xuất bản và không mặc định một mô hình đang đứng đầu nếu chưa xác minh thứ hạng.
Nhìn chung, kết quả trên Humanity’s Last Exam là một căn cứ hữu ích để tham khảo khả năng xử lý câu hỏi học thuật chuyên sâu của Gemini. Tuy nhiên, để lựa chọn mô hình cho một nhu cầu cụ thể, người dùng vẫn nên kết hợp benchmark với việc thử nghiệm trên những tác vụ thực tế tương ứng.
Từ phân tích dữ liệu, xử lý thông tin chuyên sâu đến hỗ trợ giải quyết các nhiệm vụ phức tạp, Google Gemini mở ra nhiều cơ hội ứng dụng AI vào quy trình làm việc, giúp doanh nghiệp tiết kiệm thời gian và nâng cao hiệu suất. Việc lựa chọn mô hình và giải pháp phù hợp sẽ giúp khai thác hiệu quả hơn tiềm năng của AI trong thực tế.
Gemini.vn thuộc HVN Group cung cấp thông tin và giải pháp hỗ trợ cá nhân, doanh nghiệp tìm hiểu cách khai thác Google Gemini theo nhu cầu sử dụng. Bạn có thể tham khảo bảng giá hoặc đăng ký tư vấn để được hỗ trợ lựa chọn phương án phù hợp.
Câu hỏi thường gặp
- Humanity’s Last Exam là gì và có bao nhiêu câu hỏi?
Humanity’s Last Exam (HLE) là benchmark đánh giá năng lực của các mô hình AI thông qua những câu hỏi học thuật chuyên sâu thuộc hơn 100 lĩnh vực. Bộ HLE gốc được hoàn thiện với 2.500 câu hỏi công khai vào ngày 03/04/2025. HLE-Rolling là một nhánh cập nhật riêng, vì vậy cần xác định phiên bản trước khi so sánh kết quả đánh giá.
- Humanity’s Last Exam do đơn vị nào phát triển?
Humanity’s Last Exam (HLE) được phát triển bởi Center for AI Safety (CAIS) và Scale AI, với sự đóng góp của các chuyên gia từ nhiều lĩnh vực học thuật trên thế giới.
- Humanity’s Last Exam có miễn phí không?
Bộ câu hỏi và thông tin về benchmark có thể được tìm hiểu trên trang web chính thức của HLE. Tuy nhiên, quyền truy cập dữ liệu, công cụ đánh giá hoặc các dịch vụ liên quan có thể phụ thuộc vào điều khoản của từng nền tảng.
- Mô hình có điểm HLE cao nhất có phải là AI tốt nhất không?
Không nhất thiết. Điểm HLE cao cho thấy mô hình hoạt động tốt trên bộ câu hỏi và điều kiện đánh giá tương ứng, nhưng không phản ánh toàn bộ năng lực xử lý tác vụ thực tế. Để chọn mô hình phù hợp, cần kết hợp kết quả benchmark với việc kiểm thử trên các công việc cụ thể mà người dùng hoặc doanh nghiệp cần giải quyết.
Lời kết
Humanity’s Last Exam là một benchmark quan trọng giúp đánh giá năng lực học thuật chuyên sâu của các mô hình AI thông qua những câu hỏi khó thuộc nhiều lĩnh vực. Tuy nhiên, điểm HLE cần được xem xét trong bối cảnh phiên bản, điều kiện đánh giá và giới hạn của benchmark, thay vì dùng làm thước đo duy nhất để xác định mô hình AI tốt nhất.
Nếu doanh nghiệp đang tìm hiểu cách ứng dụng Google AI vào quy trình làm việc, Gemini.vn thuộc HVN Group là kênh tham khảo các giải pháp trong hệ sinh thái Google. Bạn có thể truy cập Gemini.vn hoặc liên hệ hotline 024.9999.7777 để trao đổi về nhu cầu triển khai phù hợp.
