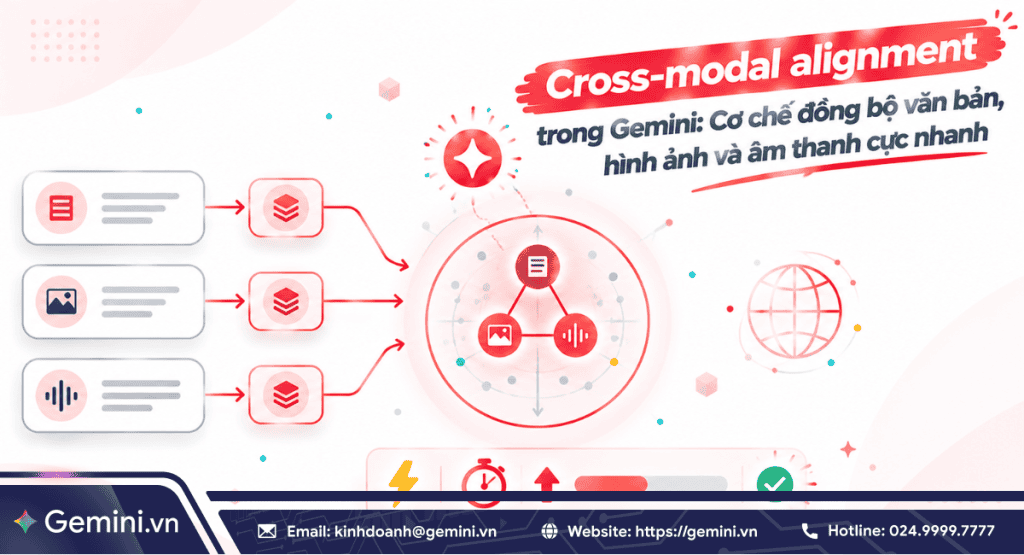
Việc ghép nối các mô hình AI riêng lẻ để xử lý đồng thời văn bản, hình ảnh và âm thanh thường gây ra độ trễ cao, lệch ngữ cảnh và tốn kém tài nguyên. Công nghệ Cross-modal alignment trong Gemini đã giải quyết triệt để vấn đề này nhờ kiến trúc đa phương thức bẩm sinh (native multimodal), giúp đồng bộ hóa mọi luồng dữ liệu vào chung một không gian nhận thức. Bài viết dưới đây Gemini sẽ phân tích chi tiết cơ chế vận hành và những ứng dụng thực tế đột phá của công nghệ này trong vận hành doanh nghiệp.
Cross-modal alignment trong Gemini là gì?
Cross-modal alignment trong Gemini là quá trình đồng bộ và ánh xạ các dạng dữ liệu khác nhau (văn bản, hình ảnh, âm thanh) vào một không gian biểu diễn ngữ nghĩa chung, giúp AI hiểu được mối liên hệ liền mạch giữa các phương thức này mà không cần thông qua các công cụ dịch thuật trung gian.
Hạn chế của phương pháp mô hình lắp ghép (Stitched Models) truyền thống:
Để thấy rõ sự khác biệt, hãy nhìn lại cách các hệ thống AI thế hệ cũ chật vật khi xử lý dữ liệu đa phương tiện qua quy trình lắp ghép rời rạc:
- Quy trình cồng kềnh: AI cũ phải kết hợp nhiều công cụ độc lập, chuyển âm thanh thành chữ (Speech-to-Text), nhận diện vật thể trong ảnh thành nhãn văn bản (Computer Vision/OCR), rồi mới đưa đoạn chữ này vào mô hình ngôn ngữ lớn (LLM) để phân tích.
- Mất mát dữ liệu quan trọng: Chữ viết thuần túy không thể mô tả độ rung, cảm xúc hoảng sợ trong giọng nói hay sắc độ tinh tế của một bức tranh.
- Suy giảm hiệu năng: Dữ liệu bị biến dạng qua từng bước chuyển đổi trung gian, dẫn đến đầu ra kém chính xác và tăng độ trễ (latency) hệ thống.
Sự đột phá từ kiến trúc đa phương thức bẩm sinh (Native Multimodal) trên Gemini:
Giải quyết triệt để rào cản của thế hệ cũ, Google Gemini mang đến bước tiến nhảy vọt nhờ thiết kế bộ não đa phương thức ngay từ nền tảng:
- Đào tạo đồng bộ ngay từ đầu (From Scratch): Gemini tiếp nhận trực tiếp điểm ảnh (pixels), sóng âm thanh (audio waveforms) và ký tự (text tokens) cùng một lúc trên tập dữ liệu hỗn hợp khổng lồ, không thông qua bước dịch thuật trung gian.
- Đồng bộ hóa bản chất ngữ nghĩa: Nhờ cơ chế Cross-modal alignment, khi Gemini nhìn thấy ảnh “quả táo”, nghe âm thanh “apple” và đọc chữ “quả táo”, hệ thống nhận diện ngay cả 3 tín hiệu đều mang chung một ý nghĩa.
- Tối ưu trải nghiệm: Giữ trọn vẹn ngữ cảnh tự nhiên, tăng độ chính xác vượt trội và đảm bảo tốc độ phản hồi siêu tốc.
Sự đột phá này mang lại tác động vô cùng to lớn, nó giải quyết triệt để bài toán gián đoạn dữ liệu, cho phép hệ thống phân tích các luồng thông tin phức tạp đan xen. Ví dụ, một kỹ sư có thể vẽ tay một sơ đồ máy móc lên bảng trắng, dùng điện thoại quay video lại và vừa quay vừa giải thích bằng giọng nói về cách máy móc đó vận hành. Gemini có thể tiếp thu trọn vẹn cả hình vẽ, chuyển động của nét bút và lời giải thích bằng âm thanh để xuất ra một bản tài liệu kỹ thuật hoàn chỉnh cực nhanh.
Cơ chế hoạt động của Cross-modal alignment trong Gemini
Cơ chế hoạt động của Cross-modal alignment trong Gemini vận hành qua ba giai đoạn kỹ thuật cốt lõi: mã hóa dữ liệu đầu vào trực tiếp, chuyển đổi vào không gian biểu diễn ngữ nghĩa chung và sử dụng mạng chú ý chéo (Cross-Attention) để liên kết thông tin.
Mã hóa dữ liệu đầu vào trực tiếp (Direct Encoding)
Khác với các AI phải chuyển mọi thứ về dạng văn bản, xử lý đa phương tiện Gemini sử dụng các bộ mã hóa (Encoder) chuyên dụng để giữ nguyên bản chất của từng loại dữ liệu.
- Với hình ảnh và video: Hệ thống không cố gắng mô tả hình ảnh bằng lời. Thay vào đó, hình ảnh được chia nhỏ thành các mảng ảnh (image patches). Video được hiểu là một chuỗi các mảng ảnh chuyển động theo dòng thời gian.
- Với âm thanh: Dữ liệu giọng nói hoặc tiếng động không bị ép đổi thành văn bản ngay lập tức. Chúng được hệ thống mã hóa dưới dạng biểu đồ phổ âm thanh (mel-spectrograms), giúp giữ nguyên được cao độ, trường độ, ngữ điệu và cả những tiếng động môi trường như tiếng chim hót hay tiếng còi xe.
- Với văn bản: Các ký tự được bộ tách từ (Tokenizer) phân rã thành các chuỗi token số học. Tất cả các quá trình mã hóa này diễn ra song song và độc lập, tạo ra các khối dữ liệu thô sẵn sàng cho bước đồng bộ.
Không gian biểu diễn chung (Shared Semantic Space)
Đây chính là trái tim của quá trình Cross-modal alignment, mọi định dạng dữ liệu sau khi được mã hóa sẽ được chuyển đổi thành các chuỗi số học phức tạp gọi là vector nhúng (embeddings). Thay vì để vector hình ảnh ở một không gian riêng và vector văn bản ở một không gian khác, hệ thống sẽ ánh xạ (map) toàn bộ các vector này vào chung một không gian toán học nhiều chiều (Shared Semantic Space).
Trong không gian này, khoảng cách giữa các vector đại diện cho mức độ liên quan về mặt ý nghĩa. Cụ thể, vector biểu diễn “hình ảnh một chú chó đang sủa”, vector biểu diễn “âm thanh tiếng chó sủa gâu gâu” và vector của cụm từ văn bản “chú chó sủa” sẽ được thuật toán kéo lại nằm sát cạnh nhau. Bằng cách thiết lập tọa độ toán học này, hệ thống phát triển được một “trực giác” sâu sắc, hiểu rằng dù dữ liệu tồn tại ở hình thức nào (mắt thấy, tai nghe hay đọc chữ), chúng đều mang một ý nghĩa thống nhất.
Cơ chế chú ý chéo (Cross-Attention Mechanism)
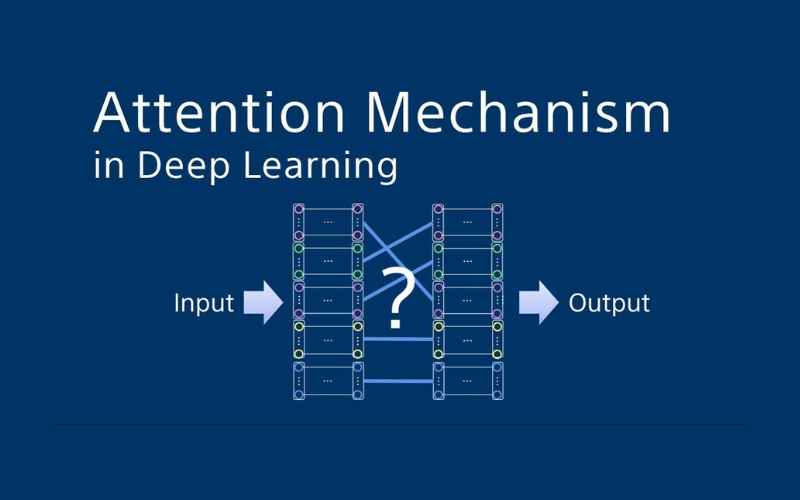
Khi dữ liệu đã được đặt chung vào một không gian, làm sao để hệ thống biết cần phải kết hợp chi tiết nào với chi tiết nào? Lúc này, mạng lưới chú ý chéo (Cross-Attention) sẽ được kích hoạt. Thuật toán này đóng vai trò như một bộ lọc thông minh, giúp AI đánh giá mức độ quan trọng giữa các yếu tố khác biệt.
Ví dụ:
Bạn tải lên một đoạn video hướng dẫn nấu ăn và hỏi: “Người đầu bếp vừa thả gia vị gì vào nồi khi anh ấy nói câu ‘Bây giờ là thành phần bí mật’?” Mạng lưới chú ý chéo sẽ thực hiện việc quét đồng bộ. Nó lấy câu hỏi bằng chữ của bạn (Text Query) đối chiếu với dòng thời gian của âm thanh (Audio Track) để tìm ra đúng giây người đầu bếp phát âm câu nói đó.
Ngay tại mốc thời gian đó, nó tiếp tục đối chiếu với mảng hình ảnh (Visual Patches) để phóng to vào vật thể đang được thả vào nồi. Nhờ cơ chế liên kết này, hệ thống đưa ra câu trả lời chính xác và cực nhanh mà không cần con người phải cung cấp thêm bất kỳ ngữ cảnh nào.
Tác động của Cross-modal alignment trong Gemini lên hiệu năng AI
Việc áp dụng Cross-modal alignment trong Gemini giúp tăng cường khả năng nhận thức ngữ cảnh sâu sắc, hạn chế ảo giác AI (Hallucination) và thúc đẩy tốc độ phản hồi cực nhanh trong các môi trường yêu cầu xử lý dữ liệu lớn.
Nhận thức ngữ cảnh sâu sắc và đa chiều
Sự kết hợp đồng bộ giữa các luồng dữ liệu đa phương thức giúp Gemini vượt xa giới hạn của các hệ thống AI thế hệ cũ, mang lại khả năng phân tích bối cảnh toàn diện và nhạy bén như tư duy con người:
Vấn đề của AI cũ: Hoạt động giống như từng giác quan riêng biệt mô hình đọc chữ thì “không thấy ảnh”, mô hình nhìn ảnh thì “không nghe được tiếng”. Điều này khiến AI hiểu thông tin một cách máy móc, dễ lệch ngữ cảnh.
Cách Gemini xử lý: Giúp AI “nhìn”, “nghe” và “đọc” cùng một lúc trong một bộ não duy nhất, cho phép tổng hợp toàn bộ bối cảnh xung quanh chỉ trong một lần tiếp nhận.
Ví dụ thực tế dễ hiểu: Bức ảnh meme một chú chó ngồi thản nhiên trong căn phòng đang bốc cháy, kèm câu thoại “Mọi thứ vẫn ổn”:
- Nếu chỉ đọc chữ: AI tưởng thật là mọi chuyện đang rất tốt đẹp.
- Nếu chỉ nhìn ảnh: AI tưởng đây là vụ hỏa hoạn nguy hiểm cần báo động khẩn cấp.
- Gemini xử lý: Đặt bức ảnh hỏa hoạn cạnh câu chữ thản nhiên để nhận ra ngay sự tương phản, từ đó hiểu đúng đây là một trò đùa mỉa mai, châm biếm.
Giá trị thực tế: AI hiểu được ẩn ý, thái độ, cảm xúc và các tình huống phức tạp của con người thay vì dịch nghĩa đen.
Tăng tốc độ phản hồi và tiết kiệm tài nguyên tính toán
Không chỉ nâng cao khả năng thấu hiểu bối cảnh, kiến trúc đa phương thức bẩm sinh của Gemini còn đem lại bước đột phá lớn về tốc độ xử lý và tối ưu hóa chi phí hạ tầng phần cứng:
Vấn đề của AI cũ: Sử dụng phương pháp “chuyền tay qua nhiều trạm dịch trung gian”:
Video đầu vào → Tách thành ảnh tĩnh → Nhận diễn chữ trong ảnh → Chuyển chữ vào AI xử lý → Trả câu trả lời
Quá trình này ngốn rất nhiều công suất máy chủ, gây lag và tăng thời gian chờ đợi.
Cách Gemini xử lý: Đưa thẳng mọi định dạng (chữ viết, hình ảnh, tiếng động) vào một không gian nhận thức chung (Shared Vector Space). Dữ liệu chạy thẳng một đường duy nhất từ đầu vào đến kết quả cuối cùng mà không cần qua các bước dịch thuật trung gian.
Giá trị thực tế:
- Giảm tối đa chi phí điện năng và máy chủ cho hệ thống.
- Phản hồi siêu tốc, phục vụ hoàn hảo cho các công việc đòi hỏi thời gian thực như: phân tích luồng camera an ninh liên tục, trợ lý ảo hội thoại giọng nói trực tiếp.
Giảm thiểu tình trạng “ảo giác AI” (tự bịa thông tin) nhờ đối soát chéo
Song song với tốc độ xử lý vượt trội, cơ chế đồng bộ đa phương thức còn đóng vai trò như một bộ lọc tự kiểm chứng, giúp giải quyết triệt để bài toán ảo giác AI và đảm bảo tính chính xác tuyệt đối cho dữ liệu đầu ra:
Vấn đề của AI cũ: Các mô hình thuần văn bản thường đoán từ tiếp theo dựa trên xác suất, dẫn đến việc tự bịa ra thông tin sai sự thật nhưng trình bày rất thuyết phục.
Cách Gemini xử lý (Cơ chế Self-Grounding): Sử dụng hình ảnh và âm thanh thực tế làm bằng chứng vật lý để kiểm chứng lại những gì câu chữ sắp sinh ra.
Ví dụ thực tế dễ hiểu:
- Khi AI sắp xuất ra câu văn: “Khách hàng trong video đang cầm một chiếc điện thoại màu đỏ”.
- Ngay lập tức, bộ phận thị giác kiểm tra lại tọa độ hình ảnh thực tế và thấy chiếc điện thoại thực chất màu xanh.
- Cơ chế chú ý chéo (Cross-Attention) lập tức chặn lỗi sai này và tự động sửa câu trả lời thành “màu xanh” trước khi hiển thị lên màn hình.
Giá trị thực tế: Mang lại độ chính xác và độ tin cậy vượt trội, giúp doanh nghiệp an tâm ứng dụng AI vào các lĩnh vực nhạy cảm như y tế, pháp lý, kiểm tra chất lượng sản phẩm hay phân tích dữ liệu tài chính.
Bốn ứng dụng thực tế của Cross-modal alignment trong Gemini
Công nghệ Cross-modal alignment trên Google Gemini mở ra 4 kịch bản ứng dụng mang lại hiệu quả vận hành và giá trị kinh tế trực tiếp cho doanh nghiệp:
Phân tích video và trích xuất dữ liệu tự động
Nhờ khả năng đồng bộ hóa hình ảnh và âm thanh theo thời gian thực, Gemini biến quá trình xử lý video cồng kềnh thành một quy trình tự động hóa thông minh:
- Bối cảnh: Doanh nghiệp an ninh, truyền thông, giáo dục trực tuyến phải rà soát hàng ngàn giờ video thủ công vô cùng tốn thời gian.
- Cách Gemini xử lý: Kết hợp phân tích chuyển động của vật thể trên màn hình với âm thanh hiện trường (ví dụ: phát hiện tiếng kính vỡ đồng thời với hình ảnh có kẻ đột nhập).
- Giá trị thực tế: Tự động đánh dấu mốc thời gian (timestamps) sự kiện quan trọng và tóm tắt nội dung chính xác mà không cần con người ngồi xem lại từ đầu.
Xử lý tài liệu kỹ thuật và biểu đồ phức tạp
Bằng việc liên kết trực tiếp cấu trúc thị giác với ngữ nghĩa văn bản, Gemini vượt qua giới hạn của các công cụ đọc ảnh thông thường để xử lý trọn vẹn những hồ sơ dữ liệu chuyên ngành phức tạp nhất:
- Bối cảnh: Tài liệu tài chính, y tế, xây dựng thường chứa biểu đồ, bản vẽ kiến trúc, công thức toán học xen kẽ ảnh chụp thực tế. Các công cụ đọc ảnh (OCR) truyền thống thường làm loạn định dạng và đứt gãy thông tin.
- Cách Gemini xử lý: Nhìn toàn bộ bố cục trang giấy, đọc chính xác các trục X-Y của đồ thị, đối chiếu ghi chú viết tay với hình ảnh minh họa bên dưới.
- Giá trị thực tế: Tự động hóa hoàn toàn khâu nhập liệu và phân tích các báo cáo chuyên sâu có cấu trúc phức tạp.
Sáng tạo nội dung truyền thông đa phương tiện
Khả năng thấu hiểu sự tương quan giữa hình ảnh, âm thanh và ngôn ngữ giúp Gemini trở thành trợ lý đắc lực, tối ưu hóa toàn bộ quy trình sản xuất nội dung cho ngành Marketing:
-
- Bối cảnh: Đội ngũ Marketing tốn nhiều chi phí và thời gian để sản xuất nội dung quảng cáo và chỉnh sửa video đa kênh.
- Cách Gemini xử lý:
Đánh giá hình ảnh & âm thanh: Nạp ảnh sản phẩm và nhạc nền vào hệ thống, AI sẽ phân tích phong cách thiết kế và nhịp điệu nhạc để tự động viết câu lời thoại (copywriting) phù hợp.
Dựng video ngắn (Shorts/Reels): Tự động tạo phụ đề chạy chữ trên màn hình, khớp chính xác từng khẩu hình miệng và sắc thái nhấn nhá giọng nói của nhân vật.
- Giá trị thực tế: Tiết kiệm hàng chục giờ dựng phim thủ công và nâng cao hiệu suất sản xuất chiến dịch truyền thông.
Chăm sóc khách hàng trực quan đa kênh
Sự đồng bộ chéo phương thức xóa bỏ hoàn toàn rào cản giao tiếp, giúp nâng cấp hệ thống hỗ trợ khách hàng lên một tầm cao mới về độ chính xác và tốc độ xử lý:
- Bối cảnh: Khách hàng gặp khó khăn khi mô tả sự cố kỹ thuật của sản phẩm chỉ bằng lời nói hoặc văn bản thuần túy.
- Cách Gemini xử lý: Cho phép khách hàng gửi một bức ảnh chụp thiết bị đang báo đèn đỏ kèm đoạn ghi âm mô tả âm thanh lạ. Hệ thống sẽ lập tức đối chiếu hình ảnh mã lỗi, tiếng động và kho dữ liệu tài liệu kỹ thuật.
- Giá trị thực tế: Chatbot tự động nhận diện lỗi kỹ thuật chính xác và gửi ngay hình ảnh hoặc video ngắn hướng dẫn khách hàng tự xử lý từng bước nhanh chóng.
Các câu hỏi thường gặp (FAQ)
Giải đáp trực diện các thắc mắc về cơ chế kỹ thuật và khả năng ứng dụng thực tiễn của Cross-modal alignment trong Gemini đối với quá trình vận hành hạ tầng công nghệ.
Cross-modal alignment trong Gemini khác gì với các AI đa phương thức thế hệ cũ?
Khác biệt lớn nhất nằm ở kiến trúc nguyên bản (native). Các AI cũ thường dùng mô hình lắp ghép (chuyển hình ảnh/âm thanh thành chữ rồi mới xử lý), gây chậm trễ và sai lệch ngữ cảnh. Gemini xử lý trực tiếp và đồng thời mọi định dạng (chữ, ảnh, âm thanh) trong cùng một hệ thống, giúp hiểu dữ liệu liền mạch và chính xác hơn.
Quá trình xử lý chéo nhiều luồng dữ liệu có làm tăng độ trễ (latency) hệ thống không?
Không, ngược lại còn làm giảm tối đa độ trễ. Bằng cách loại bỏ hoàn toàn các bước “dịch thuật” trung gian (ví dụ: bóc băng video thành chữ), dữ liệu chạy thẳng từ đầu vào đa phương tiện đến kết quả đầu ra, giúp tốc độ phản hồi diễn ra siêu tốc (real-time).
Cơ chế này giúp hạn chế tình trạng ảo giác AI (Hallucination) như thế nào?
Cross-modal alignment hoạt động như một bộ kiểm chứng nội bộ (Self-Grounding). AI sẽ dùng dữ liệu hình ảnh và âm thanh thực tế làm “bằng chứng vật lý” để tự đối chiếu với câu trả lời bằng chữ. Nếu phát hiện mâu thuẫn (ví dụ: chữ định viết “màu đỏ” nhưng ảnh là “màu xanh”), AI sẽ tự động chặn và sửa lỗi trước khi phản hồi cho người dùng.
Ứng dụng nào của Cross-modal alignment dễ triển khai nhất cho doanh nghiệp vừa và nhỏ (SME)?
SME có thể triển khai ngay vào hai mảng: Chăm sóc khách hàng trực quan (cho phép khách gửi ảnh/video sự cố để Chatbot tự nhận diện lỗi kỹ thuật chuẩn xác) và Sáng tạo nội dung Marketing (tự động hóa khâu sản xuất video ngắn, tạo phụ đề khớp khẩu hình và viết nội dung quảng cáo từ hình ảnh sản phẩm).
Khi doanh nghiệp tải video và tài liệu nội bộ lên để hệ thống phân tích, dữ liệu có được bảo mật không?
Có. Khi sử dụng các gói dịch vụ Gemini bản quyền dành cho doanh nghiệp, Google cam kết tuân thủ các tiêu chuẩn bảo mật dữ liệu cấp doanh nghiệp. Toàn bộ hình ảnh, âm thanh, video và tài liệu của bạn sẽ không bị sử dụng để huấn luyện ngược lại cho các mô hình AI công cộng.
Tổng kết
Công nghệ Cross-modal alignment trên Google Gemini là bước ngoặt tái định hình kiến trúc AI khi xóa bỏ ranh giới giữa văn bản, thị giác và thính giác. Nhờ giải quyết triệt để bài toán độ trễ, sai lệch bối cảnh và “ảo giác AI”, kiến trúc đa phương thức bẩm sinh này giúp doanh nghiệp tối ưu chi phí vận hành, tự động hóa quy trình phức tạp và kiến tạo trải nghiệm khách hàng đột phá.
Để trải nghiệm phiên bản Gemini AI mới nhất, quý khách vui lòng liên hệ với Gemini.vn qua hotline 024.9999.7777 để được tư vấn và hỗ trợ.
