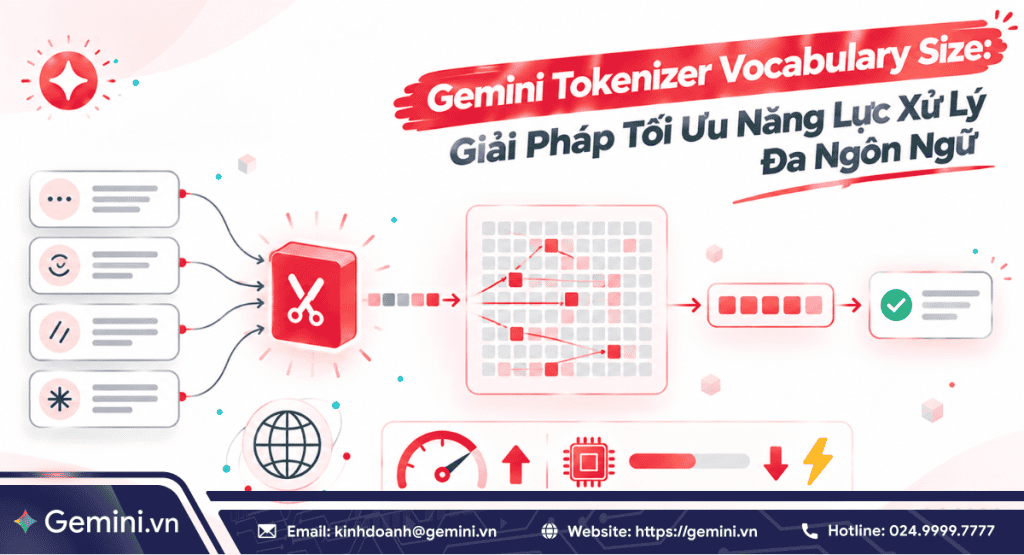
Việc sử dụng quá nhiều token cho cùng một đoạn văn bản do bộ từ điển nhỏ (Vocabulary Size) khiến chi phí API tăng cao và dễ tràn cửa sổ ngữ cảnh, đặc biệt với các ngôn ngữ phi Latinh như tiếng Việt. Để giải quyết triệt để rào cản này, Google DeepMind đã nâng cấp Gemini Tokenizer Vocabulary Size lên đến 256.000 token, giúp nén văn bản vượt trội, tối ưu chi phí và tăng tốc độ xử lý đa ngôn ngữ. Bài viết này Gemini sẽ phân tích chi tiết bản chất kỹ thuật và tác động chiến lược của cải tiến đột phá trên hệ sinh thái Gemini.
Gemini Tokenizer Vocabulary Size là gì?
Gemini Tokenizer Vocabulary Size là quy mô tập hợp các đơn vị từ vựng (tokens) được lưu trữ trong bộ tách từ của Google Gemini (đạt mốc 256.000 tokens), cho phép mô hình mã hóa văn bản và dữ liệu đa phương thức thành các mảng số nguyên với tỷ lệ nén cao và độ trễ thấp.
Để hiểu vai trò của chỉ số này, cần nhìn vào cách các mô hình ngôn ngữ lớn tiếp nhận dữ liệu. AI không thể trực tiếp đọc chữ cái hay từ ngữ của con người, mà buộc phải chuyển đổi dữ liệu thành các chuỗi số nguyên (Token IDs) thông qua một công cụ gọi là Tokenizer. Mức độ hiệu quả của Tokenizer phụ thuộc hoàn toàn vào kích thước từ điển (Vocabulary Size) tức số lượng đơn vị từ vựng duy nhất mà mô hình có thể ghi nhớ.
Trong các mô hình LLM thế hệ cũ, dung lượng từ điển thường chỉ dừng lại ở mức 32.000 đến 50.000 token. Do dung lượng hạn chế, từ điển cũ chủ yếu chứa các từ tiếng Anh phổ biến. Khi gặp các ngôn ngữ khác như tiếng Việt, Tokenizer không tìm thấy từ tương ứng trong bộ nhớ và buộc phải chẻ nhỏ một từ thành 3 đến 4 mảnh ký tự vụn. Điều này làm gia tăng số lượng token đầu vào một cách không cần thiết.
Sự nâng cấp lên mốc 256.000 token trong Gemini mang lại bước ngoặt lớn:
- Tăng gấp 8 lần dung lượng lưu trữ từ vựng: Cho phép bộ tách từ chứa nguyên khối các từ đơn, từ ghép, thuật ngữ chuyên ngành và từ khóa lập trình phổ biến của nhiều ngôn ngữ trên thế giới.
- Tối ưu hóa chỉ số Fertility Rate (Tỷ lệ phân rã token): Số lượng token trung bình cần thiết để biểu diễn một từ tiếng Việt giảm xuống đáng kể, giúp chuỗi dữ liệu nạp vào mô hình gọn gàng hơn.
- Mở rộng khả năng xử lý đa phương thức (Native Multimodality): Không chỉ mã hóa văn bản, bộ từ điển mở rộng còn phân bổ không gian lưu trữ cho các token biểu diễn điểm ảnh (image patches) và âm thanh, tạo nền tảng cho Gemini xử lý dữ liệu đa phương thức mượt mà.
Cơ chế biểu diễn và nén dữ liệu của Gemini Tokenizer Vocabulary Size
Tokenizer của Gemini chuyển đổi văn bản thành các mã số cho máy tính hiểu thông qua 4 cơ chế: bộ từ điển lớn 256.000 token, thuật toán BPE/Unigram, cơ chế xử lý ký tự lạ Byte-level Fallback và tối ưu tỷ lệ nén.
- Bộ từ điển lớn (256.000 token): Từ điển chứa 256.000 từ và cụm từ phổ biến. Nhờ dung lượng lớn, các từ tiếng Việt phức tạp (như “trí tuệ nhân tạo”, “doanh nghiệp”) hoặc các đoạn mã lập trình ngắn được gom trọn thành 1 đến 2 token thay vì bị xé nhỏ thành nhiều mảnh.
- Thuật toán tách/ghép từ (BPE & Unigram): Mô hình tự động quét văn bản và chọn cách phân chia tối ưu nhất sao cho số lượng token tạo ra là ít nhất.
- Cơ chế xử lý ký tự lạ (Byte-level Fallback): Văn bản được quy đổi về dạng chuỗi byte UTF-8. Nếu gặp ký tự hiếm, từ mới hoặc emoji chưa có trong từ điển, mô hình sẽ tách ký tự đó thành các byte cơ bản để xử lý. Điều này giúp hệ thống hoạt động liên tục và không bao giờ gặp lỗi thiếu từ (Out-of-Vocabulary).
- Tối ưu tỷ lệ nén cho ngữ cảnh dài: Việc gom văn bản thành ít token giúp giảm số lượng phép tính toán mà mô hình phải xử lý. Nhờ đó, người dùng có thể tải lên lượng tài liệu lớn hơn trong cùng một cửa sổ ngữ cảnh (Context Window) mà mô hình vẫn xử lý nhanh và mượt mà.
Tác động của Gemini Tokenizer Vocabulary Size lên hệ sinh thái Google
Tích hợp quy mô Gemini Tokenizer Vocabulary Size lớn mang lại bước ngoặt chiến lược, nâng cao bình đẳng ngôn ngữ, tăng tốc độ suy luận và tối ưu hóa chi phí vận hành cho doanh nghiệp.
Sự cải tiến này giải quyết trực tiếp bất bình đẳng kỹ thuật giữa các ngôn ngữ trên thế giới:
- Xóa bỏ thuế ngôn ngữ (Language Tax): Đối với các bộ Tokenizer cũ, người dùng tiếng Việt phải trả chi phí API đắt gấp 2 đến 3 lần so với người dùng tiếng Anh cho cùng một bài viết có nội dung tương đương, do số lượng token càng mở rộng. Bộ từ điển 256k của Gemini giúp cân bằng chỉ số này, giảm chi phí xử lý dữ liệu tiếng Việt xuống mức tối đa.
- Rút ngắn thời gian phản hồi: Tốc độ suy luận của AI phụ thuộc vào số lượng token đầu ra cần sinh ra. Do văn bản tiếng Việt được nén gọn thành ít token hơn, Gemini hoàn thành việc xuất kết quả và câu trả lời cực nhanh.
Bảng so sánh hiệu năng giữa Tokenizer truyền thống và Gemini Tokenizer
Để giúp quý độc giả và các nhà quản trị công nghệ có cái nhìn toàn diện, trực quan nhất về bước nhảy vọt kỹ thuật này, dưới đây là bảng so sánh chi tiết giữa cơ chế mã hóa (Tokenizer) truyền thống và bộ Gemini Tokenizer thế hệ mới trên các tiêu chí hiệu năng cốt lõi:
| Tiêu chí so sánh | Tokenizer truyền thống (32k – 50k) | Gemini Tokenizer (256k) |
| Quy mô từ điển (Vocabulary Size) | 32.000 – 50.000 tokens | 256.000 tokens |
| Tỷ lệ nén tiếng Việt / phi Latinh | Thấp (1 từ thường bị tách thành 2-4 tokens) | Cực cao (1 từ/cụm từ thường chỉ tốn 1 token) |
| Tốc độ xử lý đoạn văn dài | Chậm hơn do số lượng token đầu vào lớn | Nhanh hơn nhờ dung lượng token đầu vào gọn |
| Tỷ lệ lỗi Out-of-Vocabulary | Dễ gặp sự cố khi gặp ký tự hiếm | Gần như bằng 0 nhờ cơ chế Byte-level |
| Chi phí API trên cùng thông tin | Tốn kém hơn đối với dữ liệu đa ngữ | Tối ưu hơn, tiết kiệm ngân sách đáng kể |
Việc mở rộng từ điển Tokenizer lên 256.000 token không chỉ là một nâng cấp kỹ thuật, mà còn là bước đi chiến lược giúp Google Gemini tạo lợi thế cạnh tranh toàn diện. Nhờ tối ưu tỷ lệ nén và xóa bỏ thuế ngôn ngữ, Gemini giúp doanh nghiệp tiết kiệm đáng kể chi phí API, nâng cao tốc độ phản hồi và mang lại trải nghiệm bình đẳng, mượt mà cho người dùng ở mọi ngôn ngữ, đặc biệt là tiếng Việt.
Gemini Tokenizer Vocabulary Size ứng dụng trong vận hành doanh nghiệp
Gemini Tokenizer hỗ trợ doanh nghiệp vận hành hiệu quả hơn thông qua 4 ứng dụng thực tế: xử lý hợp đồng đa ngôn ngữ, tối ưu chi phí API, tăng tốc Chatbot chăm sóc khách hàng và phân tích mã nguồn lập trình.
Xử lý tài liệu và hợp đồng đa ngôn ngữ quy mô lớn
Các doanh nghiệp như xuất nhập khẩu hay tư vấn pháp lý thường xuyên làm việc với hàng ngàn văn bản, hợp đồng song ngữ (ví dụ: Việt – Anh, Việt – Trung). Nhờ bộ từ điển khổng lồ, Gemini có thể nén các tệp tài liệu này lại với dung lượng cực nhỏ. Điều này cho phép doanh nghiệp nạp trọn vẹn cả một bộ hồ sơ hàng trăm trang vào hệ thống để AI đọc hiểu, đối chiếu và phân tích cùng lúc mà không lo bị ngắt quãng hay vượt qua giới hạn dung lượng bộ nhớ.
Tối ưu chi phí vận hành trợ lý ảo và hệ thống RAG
Khi triển khai chatbot hoặc trợ lý ảo chăm sóc khách hàng, doanh nghiệp phải trả phí API dựa trên tổng số token mà AI nhận vào và xuất ra. Với khả năng gom cụm từ thông minh, Gemini làm giảm đáng kể lượng token tiêu thụ cho mỗi tương tác. Kết quả là hệ thống xử lý nhanh hơn, đồng thời doanh nghiệp tiết kiệm được một khoản lớn ngân sách duy trì hạ tầng AI hàng tháng.
Rà soát và tối ưu hóa mã nguồn lập trình
Trong các dự án phần mềm, các đoạn mã thường chứa nhiều tên hàm, biến số dài và cấu trúc lệnh phức tạp. Tokenizer của Gemini có khả năng nhận diện và nén gọn các cú pháp lập trình chuyên dụng này cực kỳ hiệu quả. Nhờ vậy, các kỹ sư công nghệ có thể tải lên toàn bộ cấu trúc dự án hoặc những đoạn code phức tạp để AI tự động dò tìm lỗi bảo mật và tối ưu hóa hiệu suất với tốc độ xử lý nhanh chóng.
Nâng cao chất lượng dịch thuật tự động
Thay vì chia nhỏ từ ngữ, Gemini có thể giữ nguyên vẹn một cụm từ ghép, thành ngữ hoặc tiếng lóng địa phương vào một token duy nhất. Việc bảo toàn khối ngữ nghĩa này giúp AI nắm bắt chính xác bối cảnh của câu văn thay vì hiểu theo nghĩa đen. Nhờ đó, các bản dịch ngôn ngữ trở nên mượt mà, chính xác và sát với văn phong giao tiếp tự nhiên của con người hơn.
Để khai thác trọn vẹn khả năng nén dữ liệu và tốc độ xử lý vượt trội từ quy mô từ điển Tokenizer của Gemini, việc đăng ký gói bản quyền chính hãng là bước đi cần thiết cho doanh nghiệp. Bạn hoàn toàn có thể tìm hiểu thêm thông tin chi tiết tại đây.
Các câu hỏi thường gặp (FAQ)
Giải đáp trực tiếp các thắc mắc kỹ thuật phổ biến giúp bạn hiểu rõ bản chất và lợi ích của Gemini Tokenizer Vocabulary Size.
Gemini Tokenizer Vocabulary Size đạt kích thước bao nhiêu?
Google Gemini nâng cấp dung lượng từ điển Tokenizer lên đến 256.000 tokens, vượt trội hơn hẳn so với mốc 32.000 – 50.000 tokens của các thế hệ mô hình ngôn ngữ lớn cũ.
Quy mô từ điển lớn hơn mang lại lợi ích trực tiếp gì cho tiếng Việt?
Giúp các từ đơn, từ ghép tiếng Việt không bị xé nhỏ thành nhiều mảnh token vụn. Điều này giảm đáng kể số lượng token cần tính toán, từ đó giảm chi phí gọi API và tăng tốc độ phản hồi của AI.
Vocabulary Size phình to có làm mô hình bị chậm do tầng Softmax đầu ra không?
Không. Google DeepMind đã tối ưu hóa thuật toán Softmax cùng cấu trúc nhúng ma trận (Embedding Layer) trên hạ tầng chip TPU v4/v5e, giúp việc tra cứu từ điển 256k diễn ra mượt mà và duy trì tốc độ tính toán cực nhanh.
Lập trình viên có cần viết lại bộ mã tách từ khi sử dụng API Gemini không?
Không. Bộ Tokenizer 256k được tích hợp sẵn ở cấp độ hạ tầng API trên Google Cloud. Khi gửi dữ liệu văn bản qua API, hệ thống sẽ tự động phân rã và nén token theo quy chuẩn tối ưu nhất.
Doanh nghiệp có thể nhận tư vấn và đăng ký bản quyền giải pháp Google AI ở đâu?
Bạn có thể đăng ký và nhận tư vấn dịch vụ qua các kênh phân phối chính thức của Google Cloud tại Việt Nam để nhận sự hỗ trợ kỹ thuật bài bản và triển khai dự án cực nhanh.
Tổng kết
Chỉ số Gemini Tokenizer Vocabulary Size lên tới 256.000 token là bước tiến nền tảng giúp Google nâng cao hiệu năng xử lý cho dòng mô hình Gemini. Bằng việc tối ưu hóa tỷ lệ nén dữ liệu đa ngôn ngữ và xóa bỏ rào cản chi phí token, công nghệ này mang lại khả năng truy xuất tri thức mượt mà với tốc độ cực nhanh, giúp các doanh nghiệp tối ưu ngân sách và nâng cao hiệu suất vận hành hiệu quả trong kỷ nguyên số.
Nếu bạn muốn trải nghiệm phiên bản Gemini AI mới nhất, hãy gọi ngay hotline 024.9999.7777 hoặc liên hệ Gemini.vn để được hỗ trợ.
